Détection IA
ZeroGPT est-il fiable ?
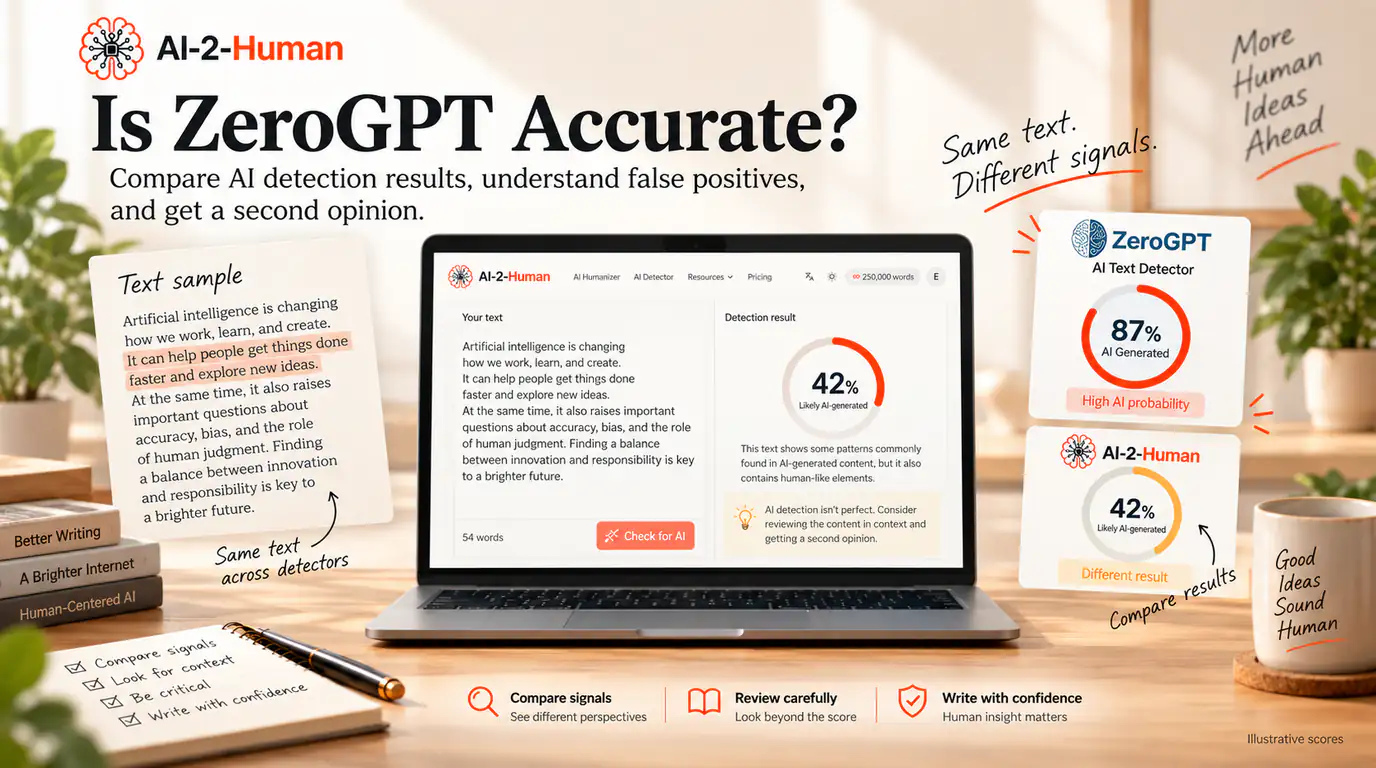
ZeroGPT distingue dans de nombreux cas un texte généré par une IA d’un texte écrit par une personne, mais il n’est pas parfaitement fiable. Les études indépendantes qui l’ont testé sur des corpus académiques et scientifiques rapportent de très bons résultats sur l’un et des résultats nettement plus faibles sur un autre, et les faux positifs comme les faux négatifs existent. Un score ZeroGPT est donc surtout utile comme signal à examiner, pas comme preuve de la façon dont un texte a été écrit. Si vous voulez un second avis, vous pouvez passer le même texte au détecteur AI-2-Human et comparer ce que chaque outil met en évidence.
Qu’est-ce que ZeroGPT ?
ZeroGPT (zerogpt.com) est un détecteur de texte IA. Vous collez un texte ou vous importez un fichier, et il renvoie un score de probabilité d’IA pour le document ainsi que les passages qu’il considère comme écrits par une IA. Le détecteur gratuit accepte jusqu’à 15 000 caractères par analyse et l’interface peut générer un rapport PDF du résultat. Sa boîte à outils plus large comprend un détecteur de plagiat, un paraphraseur et un humaniseur.
Sa propre documentation décrit le détecteur comme analysant des signaux linguistiques et statistiques appris sur du texte humain et du texte IA, notamment les motifs de tokens, la burstiness, l’entropie et les caractéristiques d’un classifieur d’ensemble. Ce qu’elle ne publie pas, ce sont les poids entraînés ni les seuils de décision, et c’est pourquoi le chiffre doit être lu comme l’estimation d’un modèle, et non comme une mesure de paternité.
ZeroGPT est-il précis ?
Il n’existe pas de pourcentage de précision unique qui s’applique à tout type d’écrit. Les estimations publiées vont de très bonnes à médiocres, et les deux extrémités viennent d’études légitimes, parce que le score d’un détecteur dépend du corpus, du genre, du modèle qui a produit le texte IA, de la longueur de l’échantillon, de l’intensité de la réécriture, du seuil retenu par les chercheurs et de la définition retenue pour « texte généré par IA ».
La FAQ de ZeroGPT indique viser plus de 98 % de précision sur ses évaluations internes, et sa page d’accueil annonce 98,4 % de précision de détection avec un taux de faux positifs inférieur à 1 %. Ces chiffres viennent des tests de l’entreprise elle-même. Les équipes indépendantes qui ont relancé le même outil sur leurs propres corpus ont rapporté des valeurs très différentes, et ce sont ces mesures qu’il faut lire avant de traiter un score comme décisif.
La réponse honnête est donc une fourchette assortie de conditions : ZeroGPT a bien séparé l’écrit humain de l’écrit généré par ChatGPT dans une étude portant sur 1 000 textes, et a nettement moins bien performé sur un corpus de résumés scientifiques dans une autre. La section suivante présente les deux mesures côte à côte.
Ce que disent les recherches indépendantes sur ZeroGPT
La première étude, publiée dans Acta Neurochirurgica en 2025, a réuni 1 000 textes : 250 résumés et introductions rédigés par des humains dans quatre revues de neurochirurgie à fort impact et publiés avant ChatGPT, plus 750 versions du même contenu générées par ChatGPT 3.5, GPT-4 et GPT-4o. Avec ZeroGPT, le score moyen de probabilité d’IA était de 27,55 % pour les textes humains, 81,48 % pour GPT-3.5, 87,39 % pour GPT-4 et 94,35 % pour GPT-4o : une séparation nette entre le groupe humain et le groupe généré. Au seuil retenu par les chercheurs, ZeroGPT atteint 94,4 % de sensibilité et 93,2 % de spécificité : il repérait donc la plupart des textes IA et écartait correctement la plupart des textes humains.
Acta Neurochirurgica : précision et limites des détecteurs de textes IA (anglais)
Le même article mesure GPTZero à 100 % de sensibilité et 99,6 % de spécificité sur ce corpus, ce qui vaut la peine d’être signalé pour deux raisons : une étude classe les outils pour ses propres textes et non dans l’absolu, et un détecteur en tête d’un benchmark garde malgré tout des erreurs dans le tableau d’ensemble décrit par les auteurs.
La deuxième étude, publiée dans PeerJ Computer Science en 2025, a comparé des résumés scientifiques rédigés par des humains à des résumés générés par ChatGPT o1 et Gemini 2.0 Pro Experimental, puis examiné un second scénario où le texte d’origine avait été amélioré par ces modèles pour la lisibilité. Sur le premier corpus, ZeroGPT atteint 64,35 % de précision globale, avec 16,67 % de faux positifs et 45,14 % de faux négatifs. Le sujet de l’article est le compromis entre précision et biais : il indique que les erreurs ne se répartissent pas également, et qu’elles pèsent davantage sur les auteurs non anglophones et sur certaines disciplines.
PeerJ Computer Science : compromis précision / biais des détecteurs de textes IA (anglais)
Une troisième étude, publiée dans Advances in Simulation en 2025, a comparé ZeroGPT, PhraslyAI et le détecteur IA de Grammarly sur cinq conditions d’usage de l’IA, allant d’introductions humaines intactes à des textes largement assistés par IA, à partir de 30 articles publiés avant 2022. Les scores bougeaient avec la condition, et les outils ne concordaient pas entre eux sur le même matériau. Ce désaccord est la leçon pratique de cette section : le chiffre est une propriété d’un texte, d’un modèle et d’un seuil, pas de la paternité d’un écrit.
Advances in Simulation : identification des différentes formes de contenu généré par IA (anglais)
Aucun de ces articles n’a trouvé de détecteur juste à tous les coups, y compris parmi les outils les mieux classés sur leur propre corpus.
ZeroGPT peut-il signaler un texte humain comme écrit par une IA ?
Oui. Un faux positif, c’est un texte humain classé comme généré par une IA, et la recherche indépendante l’a documenté avec ZeroGPT. Dans une petite étude exploratoire publiée dans l’ASEAN Journal of Open and Distance Learning, dix copies authentiques rédigées par des étudiants philippins de premier cycle ont été soumises à ZeroGPT et à un second détecteur. Les dix étaient écrites par des étudiants, et les outils ont coupé l’ensemble en deux : cinq copies étiquetées comme générées par une IA et cinq comme humaines. Les auteurs parlent d’un risque d’erreur de classement et défendent le jugement humain plutôt qu’un résultat de détecteur comme preuve.
ASEAN Journal of Open and Distance Learning : faux positifs dans la détection IA (anglais)
Dix copies, c’est un petit échantillon : lisez cette étude comme une illustration du risque, pas comme une mesure du taux d’erreur de ZeroGPT. Le corpus de PeerJ est l’avertissement plus quantitatif, avec 16,67 % de faux positifs sur des résumés scientifiques et une précision qui varie selon la catégorie d’auteur. La FAQ de ZeroGPT reconnaît d’ailleurs le mécanisme : une écriture très soignée, stéréotypée ou de faible entropie peut ressembler à de l’IA, et elle conseille des détails concrets, des sources et un rythme de phrase varié pour réduire le risque. Or l’écrit formel, stéréotypé ou rédigé dans une langue seconde est précisément le terrain où un détecteur risque le plus de se tromper.
ZeroGPT peut-il manquer un texte généré par IA ?
Oui, dans l’autre sens. Un faux négatif, c’est un texte généré par IA classé comme humain, et la même étude PeerJ mesure 45,14 % de faux négatifs sur son corpus : près de la moitié des résumés générés que le test s’attendait à voir signalés sont revenus comme humains. Dans le corpus d’Acta Neurochirurgica, la séparation était bien meilleure, avec une moyenne de 27,55 % pour le texte humain et de 81,48 % pour le texte GPT-3.5, mais les moyennes cachent la dispersion. Les échantillons individuels se recouvrent entre les deux groupes, ce qui explique précisément pourquoi un classifieur a besoin d’un seuil, et pourquoi ce seuil doit arbitrer entre les deux types d’erreur.
Un texte généré par IA n’est pas non plus une catégorie homogène. Une sortie brute de modèle, un brouillon légèrement reformulé et un texte généré puis réécrit à la main sont des objets différents pour un classifieur, et l’étude d’Advances in Simulation montre des scores qui évoluent avec le degré d’implication de l’IA. Un score faible n’établit donc pas qu’un texte est humain, de la même façon qu’un score élevé n’établit pas qu’il est écrit par une machine.
Pourquoi les résultats de ZeroGPT varient
Si le même passage obtient des scores très différents selon le test, c’est attendu et non un dysfonctionnement. Les variables ci-dessous expliquent l’essentiel de ces écarts, et ce sont aussi les raisons pour lesquelles un score se transpose mal d’un contexte à un autre.
- La longueur du texte : ZeroGPT recommande au moins 150 à 200 mots pour une lecture stable, et indique que 500 à 1 000 mots ou plus améliorent la fiabilité. Un paragraphe court apporte peu d’indices dans un sens comme dans l’autre.
- Le genre : une prose académique, un texte marketing, un essai personnel et une documentation technique ont des rythmes différents, et un modèle entraîné sur des corpus mixtes les traite inégalement.
- Le modèle générateur : GPT-3.5, GPT-4 et GPT-4o écrivent différemment, et l’étude Acta Neurochirurgica mesure des scores de probabilité d’IA de plus en plus élevés selon ces versions.
- La réécriture : un texte généré puis fortement retravaillé se situe entre les deux catégories, là où les détecteurs sont les moins stables.
- Le style humain : une écriture formelle, stéréotypée ou rédigée dans une langue seconde peut correspondre à des schémas statistiques associés au texte machine, et l’étude PeerJ constate des écarts de précision selon la catégorie d’auteur.
- Le seuil : un classifieur doit choisir une frontière de décision, et la déplacer échange des faux positifs contre des faux négatifs. ZeroGPT ne publie pas son propre seuil.
- La version du produit : les systèmes de détection sont réentraînés et mis à jour, donc un résultat d’il y a un an peut ne pas se reproduire aujourd’hui.
Ces variables plaident pour traiter tout score isolé comme provisoire, et pour confronter un résultat important à une seconde lecture plutôt qu’à votre intuition sur l’outil.
Comment interpréter un score ZeroGPT
Un pourcentage ZeroGPT est une estimation produite par un modèle. Il n’établit ni la paternité, ni un plagiat, ni une faute, ni qui a écrit une phrase précise, et il n’a jamais été conçu pour cela. Lisez-le comme un indicateur : il dit où un modèle a réagi au texte, pas ce qui s’est passé pendant sa rédaction.
Quelques questions à se poser avant d’agir sur un score :
- Le texte est-il assez long pour une lecture significative ? En dessous de 150 mots, un score est une preuve faible.
- Quels passages ont été surlignés, et vous semblent-ils stéréotypés lorsque vous les relisez ?
- Un second détecteur signale-t-il les mêmes passages ?
- Existe-t-il des traces du processus de rédaction, comme des brouillons, des notes ou un historique de versions ?
- Ce résultat changerait-il une décision concernant une personne ? Si oui, qui devrait l’interpréter avec vous ?
ZeroGPT peut-il servir de preuve d’une rédaction par IA ?
Non. Un résultat de détecteur est un élément parmi d’autres, et les études citées ci-dessus documentent les deux types d’erreur sur des corpus réels. Une institution qui traite un score isolé comme une preuve s’expose à de fausses accusations, et l’article de PeerJ montre que ces erreurs ne se répartissent pas équitablement : les auteurs non anglophones en portent davantage, ce qui aggrave les conséquences au lieu de les atténuer.
Quand la paternité d’un texte compte, les preuves les plus solides portent sur le processus : brouillons, historique de versions, notes, références, capacité de l’auteur à discuter du travail et règles applicables. Un détecteur peut vous indiquer des passages qui méritent une discussion. Il ne peut pas dire ce qui s’est passé, et il ne faut pas le lui demander.
Que faire si ZeroGPT signale votre texte ?
Si le résultat compte, traitez-le au lieu de le réécrire par réflexe. La plupart des passages signalés relèvent de deux groupes : un écrit qui a réellement besoin d’être retravaillé, et un écrit simplement formel ou prévisible dans son style. Seul le premier mérite des modifications, et les étapes ci-dessous servent à faire la différence.
- 1
Lire
Relisez le passage surligné et jugez-le comme un texte.
- 2
Comparer
Passez le même texte à un second détecteur et comparez.
- 3
Examiner
Cherchez les structures répétées, les transitions vides et les affirmations vagues.
- 4
Vérifier
Contrôlez séparément l’argumentation, les faits et les références.
- 5
Justifier
Rassemblez brouillons et historique de versions si la paternité est contestée.
- 6
Réécrire
Ne reprenez que les passages qui en ont réellement besoin.
Parfois, le signalement pointe une faiblesse réelle : des paragraphes construits sur une seule structure de phrase, des transitions qui ne relient rien, des affirmations sans exemple. Dans ce cas, l’humaniseur AI-2-Human peut réécrire le passage répétitif ou stéréotypé en une version plus naturelle tout en conservant votre sens initial, et vous retravaillez ensuite le résultat avec votre propre voix.
Faut-il comparer ZeroGPT avec un autre détecteur IA ?
Oui, en particulier lorsque le résultat a des conséquences. Les détecteurs utilisent des modèles, des données d’entraînement et des seuils différents : le désaccord entre deux outils est donc normal, et non la preuve que l’un est cassé. Cette page en est elle-même l’exemple : le même outil a obtenu des scores très différents selon les corpus, et les outils se classent différemment au sein d’une même étude.
La comparaison aide dans les deux sens. Si deux détecteurs signalent le même passage, ce passage mérite une lecture attentive. S’ils divergent nettement, ce désaccord indique que le texte se situe près d’une frontière de décision et que le chiffre est fragile, ce qui vaut la peine d’être su avant de réécrire quoi que ce soit ou avant qu’une autre personne agisse sur ce résultat.
Le détecteur AI-2-Human restitue sa propre lecture du texte et désigne les passages qui semblent encore générés, ce qui vous permet de mettre deux interprétations côte à côte avant de décider quoi modifier.
Avant de rendre votre texte : les points à vérifier
- Je traite le résultat ZeroGPT comme un signal, pas comme une preuve.
- J’ai relu les passages qui ont déclenché le signalement.
- J’ai tenu compte de la longueur et du type de texte analysé.
- J’ai comparé le résultat avec un autre détecteur parce que l’enjeu le justifiait.
- J’ai vérifié si l’écrit est réellement répétitif ou stéréotypé.
- J’ai conservé mes brouillons ou mon historique de versions là où la paternité pouvait être contestée.
- J’ai vérifié les faits et les références indépendamment de la détection IA.
- Je n’ai réécrit que les passages qui en avaient réellement besoin.
Questions fréquentes
ZeroGPT distingue efficacement un texte généré par IA d’un texte humain sur certains corpus, mais sa précision n’est pas constante selon le type d’écrit. Les études indépendantes rapportent de très bonnes performances dans un test académique et des performances nettement plus faibles dans un autre. Les faux positifs et les faux négatifs sont tous deux possibles : le résultat est donc à traiter comme un signal, pas comme une preuve définitive.
Il n’existe pas de chiffre unique. Dans une étude sur 1 000 textes publiée dans Acta Neurochirurgica, ZeroGPT atteint 94,4 % de sensibilité et 93,2 % de spécificité au seuil choisi par les chercheurs. Dans une étude de PeerJ Computer Science sur des résumés scientifiques, il atteint 64,35 % de précision, avec 16,67 % de faux positifs et 45,14 % de faux négatifs. Ce sont deux mesures réelles sur des corpus différents, et c’est pourquoi l’annonce de plus de 98 % de ZeroGPT décrit ses évaluations internes plutôt qu’un résultat universel.
Oui. Les deux types d’erreur sont documentés par la recherche indépendante : du texte humain classé comme IA, et du texte généré classé comme humain. Le taux dépend du corpus, du genre, du modèle générateur, de la longueur du texte et du seuil utilisé, donc aucun résultat isolé ne doit être traité comme définitif.
Oui. Une petite étude exploratoire portant sur dix copies d’étudiants authentiquement humaines a montré que ZeroGPT et un second détecteur en classaient cinq comme générées par une IA et cinq comme humaines, alors que les dix étaient écrites par des étudiants. Une étude plus large sur des résumés scientifiques mesure 16,67 % de faux positifs, avec davantage d’erreurs pour les auteurs non anglophones et pour certaines disciplines.
Une écriture formelle, très soignée ou répétitive peut ressembler aux schémas qu’un détecteur associe à un texte machine, et un échantillon court lui donne peu de matière. La documentation de ZeroGPT fait le même constat et conseille d’ajouter des détails concrets, des sources et un rythme de phrase varié. Si un passage est réellement stéréotypé, le réécrire aide ; s’il est simplement formel, le score en dit plus sur le détecteur que sur l’écrit.
Oui. Une étude indépendante mesure 45,14 % de faux négatifs sur son corpus de résumés scientifiques, et les performances évoluent aussi avec le modèle utilisé, le prompt et l’ampleur des modifications après génération. Un score d’IA faible n’établit pas qu’un texte a été écrit par une personne.
ZeroGPT indique viser plusieurs familles de modèles de langage et pas seulement ChatGPT, et l’étude d’Acta Neurochirurgica mesure des scores de probabilité d’IA de plus en plus élevés pour les textes de GPT-3.5, GPT-4 et GPT-4o. Cela ne signifie ni que chaque passage de ChatGPT sera signalé, ni qu’un signalement prouve l’usage de ChatGPT.
Sur les deux corpus cités dans cette page, les mesures rapportées pour GPTZero sont supérieures à celles de ZeroGPT : 100 % de sensibilité contre 94,4 % dans l’étude Acta Neurochirurgica, et 97,22 % de précision contre 64,35 % dans l’étude PeerJ. C’est un résultat propre à ces tests, pas un classement universel : les corpus, les seuils et les versions des produits changent, et les deux outils produisent encore des erreurs. Comparez sur votre propre texte plutôt que de présumer un ordre.
Oui, et c’est fréquent. Des modèles, des données d’entraînement et des seuils de décision différents font qu’un même passage peut être lu différemment par deux outils. L’étude d’Advances in Simulation a comparé trois détecteurs sur cinq conditions d’usage de l’IA : les scores variaient avec la condition et les outils ne concordaient pas entre eux.
Pas comme preuve unique. Les taux de faux positifs documentés, et le constat que ces erreurs pèsent davantage sur les auteurs non anglophones, plaident pour traiter un résultat de détecteur comme le point de départ d’une discussion sur le travail. Les brouillons, l’historique de versions, les notes et la capacité de l’étudiant à parler du sujet pèsent plus qu’un score isolé.
Relisez vous-même les passages surlignés, comparez le résultat avec un autre détecteur, examinez l’écrit pour y repérer les structures répétées et les transitions vides, vérifiez vos faits et vos références, et conservez vos brouillons. Reprenez les passages réellement stéréotypés plutôt que de réécrire un texte déjà clair. AI-2-Human peut prendre en charge la réécriture et vous donner un second signal de détection.
Oui, lorsque l’enjeu le justifie. Une seconde lecture indique si un résultat est stable d’un outil à l’autre ou s’il dépend de celui que vous avez utilisé. Quand les deux détecteurs signalent le même passage, ce passage mérite un examen ; quand ils divergent nettement, le score est fragile et ne doit rien décider à lui seul.
Vérifier avec le détecteur IA →Oui. Le détecteur AI-2-Human vous donne un autre signal de détection sur le même texte et désigne les passages qui semblent générés, ce qui permet de comparer deux interprétations avant de décider quoi modifier. Il restitue sa propre lecture, et non une copie du modèle de ZeroGPT.
Lancer le détecteur IA →Un outil de réécriture modifie le texte, et un texte différent peut être évalué différemment, mais personne ne peut promettre un chiffre précis : les détecteurs et leurs seuils évoluent en permanence. C’est pourquoi l’approche utile consiste à améliorer un écrit qui en a réellement besoin, puis à vérifier à nouveau et à comparer. AI-2-Human réécrit les passages répétitifs et stéréotypés en une version plus naturelle tout en conservant votre sens.
Humaniser un texte IA →Sources et notes éditoriales
- ZeroGPT : détecteur IA (anglais)
- ZeroGPT : questions fréquentes (anglais)
- Acta Neurochirurgica : précision et limites des détecteurs de textes IA (anglais)
- PeerJ Computer Science : compromis précision / biais des détecteurs (anglais)
- Advances in Simulation : identification des contenus générés par IA (anglais)
- ASEAN Journal of Open and Distance Learning : faux positifs dans la détection IA (anglais)
AI-2-Human n’est ni affilié à ZeroGPT ni approuvé par ZeroGPT. Les informations produit ZeroGPT et les recherches citées ont été consultées le 20 septembre 2026 ; le comportement des détecteurs et les fonctionnalités des produits peuvent évoluer.
Mis à jour le