Guías de detección de IA
¿GPTZero es fiable?
GPTZero identifica correctamente textos generados por IA en muchas situaciones, pero no existe un porcentaje único de precisión que valga para cualquier texto. El benchmark del propio GPTZero declara resultados muy altos en cuatro dominios en inglés, mientras que los estudios independientes muestran un rendimiento que cambia con la versión del detector, el tipo de texto, la longitud y el corpus evaluado. Hay falsos positivos y falsos negativos documentados. Eso hace que GPTZero sea útil como señal de detección, pero no una prueba indiscutible de cómo se escribió un texto. Cuando el resultado importa, pasar el mismo fragmento por el Detector de AI-2-Human te da otra señal antes de concluir nada.
¿Qué es GPTZero?
GPTZero es un detector de texto de IA. Pegas un texto o subes un documento y su sistema de aprendizaje profundo estima qué parte de ese texto fue escrita por una máquina. Devuelve una de tres clasificaciones del documento (escrito íntegramente por una persona, íntegramente por una IA o por una mezcla de ambas) junto con una categoría de confianza, y resalta las frases que más contribuyeron al resultado. GPTZero también describe capacidades adicionales de detección dirigidas a texto alterado con herramientas de paráfrasis.
¿Qué precisión tiene GPTZero?
No hay un porcentaje único de precisión de GPTZero que valga para cualquier texto. Los resultados declarados dependen de la versión del modelo del detector, de cómo se construyó el benchmark, de qué escritura humana se usó, de qué modelo de IA generó el texto automático, del género, de la longitud del texto, de si el texto se editó o parafraseó después, del umbral de clasificación que eligieron quienes probaron y del idioma evaluado.
Por eso esta guía mantiene separadas dos clases de pruebas. La primera es lo que GPTZero declara sobre su propio modelo, en su propio benchmark y con una versión de modelo indicada. La segunda es lo que midieron investigadores independientes cuando pasaron GPTZero por sus propios textos, que es otra pregunta: probaron la versión disponible entonces, con su corpus y con un umbral que ellos eligieron. Ambas son útiles y ninguna sustituye a la otra.
La respuesta corta para quien tiene un documento concreto es, por tanto, condicional: GPTZero puede ser muy eficaz con escritura parecida a aquella con la que fue entrenado y evaluado, y su documentación publicada reconoce que las muestras cortas, el texto de IA muy modificado, los géneros poco habituales y la escritura procedimental son casos más difíciles.
Qué declara el benchmark actual de GPTZero
GPTZero publica una página de evaluación estandarizada que, según indica, se actualiza cada trimestre, con predicciones sin procesar disponibles para quienes quieran reproducir los resultados. En su evaluación de febrero de 2026, GPTZero declara, como promedio de cuatro dominios en inglés para la versión de modelo 4.3b, una tasa de falsos positivos del 0,08%, un recall del 99,60%, una precisión del 99,93% y una exactitud del 99,76%. Cada benchmark usa 1.000 textos humanos y 1.000 textos generados por LLM, repartidos de forma uniforme entre los modelos evaluados (250 textos por modelo), y el conjunto de modelos se renueva cada trimestre.
Las filas por dominio se publican por separado, lo cual importa porque los promedios ocultan variación. GPTZero declara un 99,85% de exactitud en reseñas de artículos académicos (0,10% de falsos positivos), un 99,80% en escritura creativa, un 100% en ensayos con una tasa de falsos positivos del 0,00% y un 99,40% en reseñas de productos. La misma página recoge las puntuaciones que midió para detectores competidores sobre los mismos textos, y la comparación es más ajustada en algunos dominios de lo que sugiere el promedio titular.
Qué dice la investigación independiente sobre la precisión de GPTZero
El resultado independiente más sólido para GPTZero proviene de un estudio revisado por pares publicado en Acta Neurochirurgica en 2025. Los investigadores reunieron 1.000 textos: 250 resúmenes e introducciones escritos por personas, procedentes de cuatro revistas de neurocirugía de alto impacto publicadas antes de ChatGPT, más 750 versiones del mismo material generadas por ChatGPT 3.5, GPT-4 y GPT-4o. Los detectores se usaron entre el 1 y el 15 de junio de 2024, lo que fecha la versión de GPTZero evaluada. Con GPTZero, la puntuación media de probabilidad de IA fue del 5,88% para los textos humanos, del 81,71% para GPT-3.5, del 96,83% para GPT-4 y del 99,58% para GPT-4o. Con el punto de corte que eligieron los investigadores, GPTZero alcanzó una sensibilidad del 100% y una especificidad del 99,6%.
Acta Neurochirurgica: precisión y limitaciones de los detectores de textos de IA
Es un resultado sólido, y sigue siendo condicional. Describe un corpus académico, de una disciplina, con longitudes de texto concretas, frente a tres versiones de ChatGPT, sobre la versión de GPTZero disponible en junio de 2024 y con un umbral elegido por los autores. No significa que el detector tenga un 99,6% de exactitud sobre tu texto, y el mismo artículo señala que ningún detector de los que evaluó fue fiable en todas las situaciones.
Trabajos independientes anteriores muestran hasta qué punto pueden cambiar esas condiciones. Un estudio preliminar publicado en el Journal of Korean Medical Science en 2023 probó GPTZero con 20 textos generados por ChatGPT en respuesta a preguntas médicas y 30 fragmentos tomados de artículos médicos ya publicados. Declaró una sensibilidad de 0,65 (intervalo de confianza del 95%: 0,41 a 0,85), una especificidad de 0,90 (0,73 a 0,98) y una exactitud de 0,80 (0,66 a 0,90), y concluyó que GPTZero tenía una tasa baja de falsos positivos pero una tasa alta de falsos negativos: rara vez acusaba a la escritura humana y a menudo dejaba pasar la escritura automática.
Journal of Korean Medical Science: rendimiento de GPTZero con textos médicos generados por IA (2023)
La distancia entre esa instantánea de 2023 y el estudio de 2025 no es una contradicción ni prueba de que un equipo fuera descuidado. Es el ejemplo más claro de esta página de por qué la precisión de un detector hay que leerla junto con su versión y su corpus.
¿Puede GPTZero marcar escritura humana como IA?
Sí. Un falso positivo es escritura humana clasificada como IA o mixta, y GPTZero reconoce que esos casos existen. Su documentación de soporte explica que la exactitud aumenta a medida que se envía más texto, que su clasificador está entrenado sobre todo con prosa en inglés escrita por adultos y que a veces puede marcar como escritos por IA otros textos generados por máquinas o muy procedimentales. Un extracto corto, un fragmento formulaico o un texto muy alejado de esa distribución de entrenamiento son los puntos donde se concentra ese riesgo.
GPTZero: ¿cuáles son las limitaciones de su clasificador de IA?
La documentación pública de GPTZero va más lejos que la de la mayoría de los proveedores sobre las consecuencias de ese riesgo. Afirma que los resultados no deben usarse para castigar a estudiantes, recomienda tratar una clasificación como un componente de una valoración más amplia y sostiene que el detector debe servir como punto de partida de una conversación y no como veredicto final. En contextos académicos, la empresa también afirma que prefiere dejar pasar un uso de IA antes que acusar a una persona: su documentación de la API desaconseja aumentar la sensibilidad del detector en usos académicos, porque ahí los falsos negativos son preferibles a los falsos positivos.
¿Puede GPTZero dejar pasar texto generado por IA?
Sí, y el propio equilibrio que elige el proveedor lo hace explícito: un falso negativo es texto generado por IA clasificado como humano, y GPTZero afirma que en un contexto académico prefiere equivocarse en esa dirección. El estudio médico de 2023 midió el coste práctico de esa misma preferencia, con una sensibilidad de 0,65 en su corpus: aproximadamente un tercio de los textos escritos por máquina no fueron marcados.
Varios factores empujan un fragmento generado hacia la clasificación humana. El texto generado y luego reescrito en profundidad a mano ya no se parece a una salida cruda de modelo, y la documentación de GPTZero señala que su clasificador no se entrenó para identificar texto generado por IA después de una modificación intensa. Las herramientas de paráfrasis, los modelos poco conocidos, los géneros inhabituales, las muestras cortas y las ediciones deliberadas para engañar al detector están en la misma zona. La empresa actualiza sus modelos para estos casos, y por eso también un resultado de una versión no se hereda automáticamente en la siguiente.
Por qué varía la precisión de GPTZero
Cuando dos estudios declaran cifras muy distintas para la misma herramienta, la explicación suele estar en el diseño de la prueba y no en la herramienta. Las variables siguientes cubren casi toda la diferencia.
- Versión del modelo: el detector evaluado en 2023, el evaluado en junio de 2024 y el modelo actual son sistemas distintos, y GPTZero documenta ella misma los cambios de versión.
- Construcción del benchmark: qué textos se eligieron, cómo se dieron las instrucciones para generar los textos de IA y si las muestras están equilibradas entre géneros determinan el resultado.
- Escritura humana usada como control: la prosa académica anterior a ChatGPT, los ensayos de estudiantes y la escritura web son distribuciones distintas, y un clasificador puede parecer excelente en una y flojo en otra.
- Modelo generador: el estudio de Acta Neurochirurgica midió puntuaciones medias de GPTZero que subían del 81,71% con GPT-3.5 al 99,58% con GPT-4o, así que la misma herramienta lee modelos distintos de forma distinta.
- Género e idioma: GPTZero afirma que rinde mejor con textos largos y prosa en inglés, que es donde están la mayor parte de sus datos de entrenamiento.
- Longitud del texto: más texto significa más pruebas, y por eso los resultados a nivel de documento son más fiables que los de frase.
- Edición y paráfrasis: una reescritura humana intensa o una paráfrasis automática alejan un texto de los patrones que aprendió el clasificador.
- Umbral: todos los detectores convierten puntuaciones en decisiones con algún punto de corte, y moverlo intercambia falsos positivos por falsos negativos. El estudio de Acta indica su propio punto de corte, y esa es una razón por la que sus cifras son precisas y no universales.
- Qué se considera acierto: los estudios tratan de forma distinta las clasificaciones mixtas, el texto de IA parcial y los documentos irregulares, así que dos artículos pueden medir la misma herramienta y entender cosas distintas por exactitud.
¿Afecta la longitud del texto a la precisión de GPTZero?
Sí, y GPTZero lo dice directamente. Su documentación afirma que la exactitud mejora cuando se envía más texto y que las clasificaciones a nivel de documento son en general más fiables que las de párrafo, que a su vez son más fiables que las de frase.
Vale la pena recordar la consecuencia práctica la próxima vez que veas una frase resaltada. Una sola frase resaltada es una señal débil por sí misma, porque es lo que menos pruebas aporta de todo lo que examina el detector. Una clasificación coherente a nivel de documento sobre un ensayo completo, donde los mismos patrones aparecen en varios párrafos, merece más peso. Si el texto que compruebas es corto, trata el resultado como provisional y comprueba más parte de él.
Cómo interpretar un resultado de GPTZero
GPTZero no devuelve un solo número, y leer su salida como “el X por ciento de este ensayo lo escribió una IA” es un malentendido. El sistema devuelve una clasificación (solo humano, mixto o solo IA), una probabilidad para cada una de esas clases y una categoría de confianza alta, media o baja. La probabilidad de la clase predicha se describe en la documentación de GPTZero como la probabilidad de que el detector acierte en esa predicción: una cifra del 90% significa que, con documentos similares, acierta aproximadamente el 90% de las veces.
GPTZero: ¿cómo convierto las probabilidades de la API en resultados?
GPTZero también publica qué significan sus categorías de confianza en la práctica: con confianza alta, declara que el 99,1% de los artículos humanos se clasifican como humanos y que el 98,4% de los artículos de IA se clasifican como IA. Un resultado de confianza media o baja es, por construcción, una afirmación más blanda, y la documentación describe umbrales que puedes ajustar para intercambiar sensibilidad por falsos positivos según tu propio caso de uso.
Preguntas que conviene hacerse antes de actuar a partir de un resultado:
- ¿Cuánto texto hay y el veredicto es a nivel de documento o de frase?
- ¿La confianza es alta, media o baja?
- ¿Qué fragmentos provocaron la clasificación?
- Cuando lees esos fragmentos, ¿el texto parece de verdad repetitivo o formulaico?
- ¿Otro detector devuelve una señal parecida sobre el mismo texto?
- ¿Hay pruebas del proceso de escritura, como borradores, notas o un historial de versiones?
- ¿Se editó o parafraseó el texto de forma sustancial después de generarlo?
Lo que un resultado de GPTZero no puede establecer por sí solo es el plagio, la falta grave, la intención ni la historia exacta de un documento. Es una prueba sobre patrones del texto, y resulta más útil cuando se lee junto al texto mismo.
¿Debería el profesorado usar GPTZero como prueba de uso de IA?
No como prueba, y la propia documentación de GPTZero dice lo mismo. Sus páginas de soporte afirman que ningún detector es totalmente preciso, que los resultados no deben usarse para castigar a estudiantes y que una clasificación se trata mejor como un elemento de una valoración más amplia. La empresa también documenta su preferencia en contextos académicos: prefiere dejar pasar escritura asistida por IA antes que acusar a un estudiante por error, que es justo lo contrario de lo que necesita una decisión disciplinaria.
Cuando la autoría importa, un proceso es más fuerte que una puntuación. Las pruebas útiles incluyen el historial de redacción, las revisiones del documento, las notas de fuentes, trabajos anteriores del mismo estudiante, citas que se pueden comprobar, conversación sobre el material y lo que permita realmente la política de IA de la tarea. Un detector puede señalar fragmentos que merecen una conversación. No puede sustituir esa conversación.
Qué hacer si GPTZero marca tu texto
Si el resultado importa, recórrelo en un orden fijo en lugar de reescribir por reflejo.
- 1
Lee
Lee los fragmentos marcados y júzgalos como escritura.
- 2
Mira el nivel
Anota si la clasificación es a nivel de documento o de frase.
- 3
Pondera la confianza
Fíjate en la categoría de confianza, no solo en el resultado titular.
- 4
Compara
Pasa el mismo texto por un segundo detector.
- 5
Pruebas
Reúne borradores e historial de versiones si se cuestiona la autoría.
- 6
Revisa
Reescribe solo los fragmentos que de verdad necesitan mejorar.
A veces la preocupación está justificada: formas de frase repetidas, transiciones que no conectan nada, afirmaciones sin ningún ejemplo detrás. Cuando un fragmento es realmente formulaico, el Humanizador de AI-2-Human puede reescribirlo en un borrador más natural manteniendo tu intención en el centro, y después editas el resultado con tu propia voz.
¿Deberías comparar GPTZero con otro detector de IA?
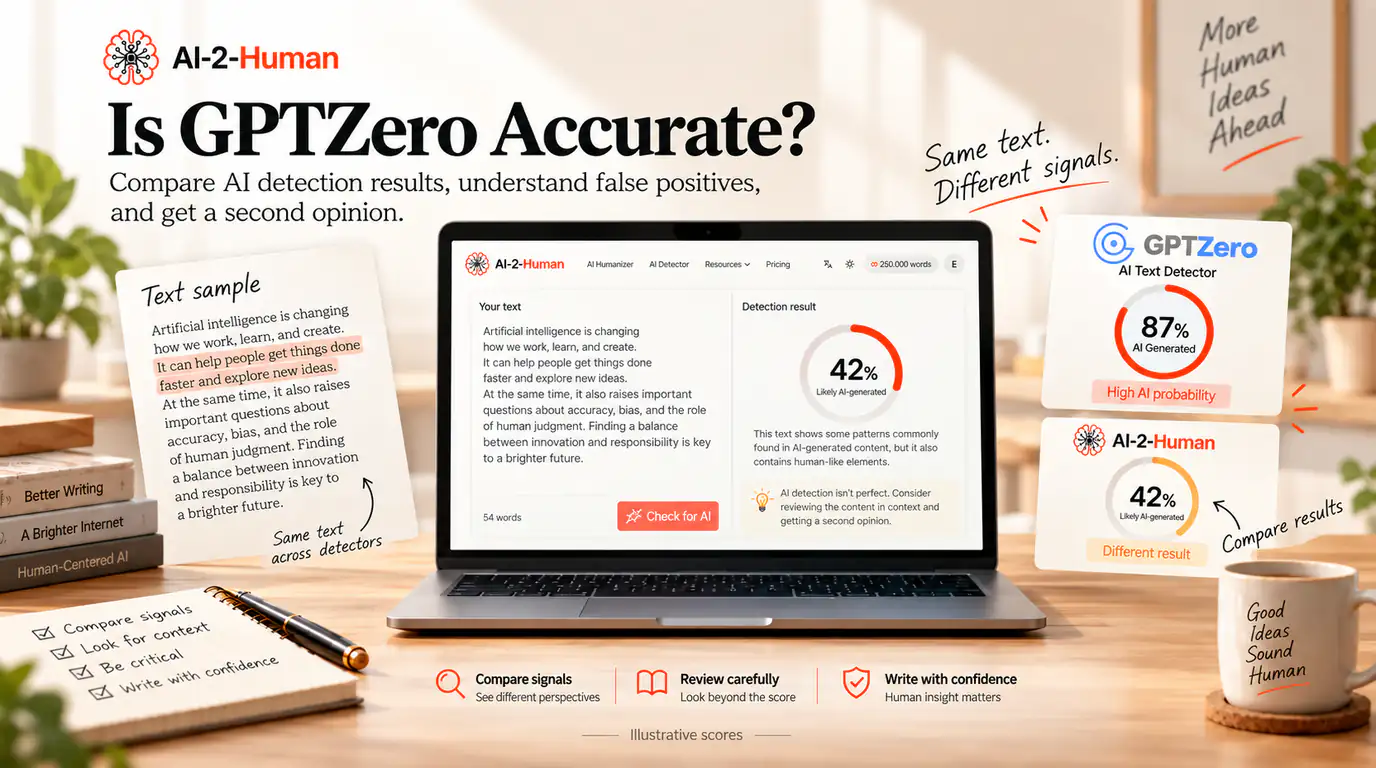
Sí, sobre todo cuando el resultado tiene consecuencias. Los detectores usan modelos distintos, datos de entrenamiento distintos y umbrales de decisión distintos, así que el mismo fragmento puede dar resultados diferentes. Los estudios citados en esta página son en sí mismos un ejemplo de cuánto importan las condiciones: la misma herramienta puntuó muy distinto según el corpus y la versión.
La comparación ayuda en las dos direcciones. Cuando dos detectores señalan el mismo fragmento, ese fragmento merece una mirada atenta. Cuando discrepan de forma marcada, la discrepancia te dice que el texto está cerca de un límite de decisión y que la puntuación es blanda, algo útil que saber antes de reescribir nada o antes de que otra persona actúe a partir del resultado.
El Detector de AI-2-Human informa de su propia lectura del texto y señala los fragmentos que todavía parecen generados, lo que te da dos interpretaciones para poner una al lado de la otra antes de decidir qué cambiar.
Antes de entregar: lista de comprobación práctica
- He comprobado si el resultado es a nivel de documento o de frase.
- He tenido en cuenta la longitud y el tipo del texto evaluado.
- He mirado la confianza de GPTZero y no solo la clasificación titular.
- He leído los fragmentos que provocaron la duda.
- He tratado el resultado como una prueba y no como una demostración.
- He comparado con otro detector porque el resultado importa.
- He guardado borradores o historial de versiones allí donde podría cuestionarse la autoría.
- He verificado hechos y citas aparte de la detección de IA.
- He revisado solo los fragmentos que de verdad necesitaban mejorar.
Preguntas frecuentes
GPTZero rinde muy bien en sus propios benchmarks y en al menos un corpus académico independiente, pero no hay un porcentaje universal de precisión para todo tipo de texto. Los resultados declarados cambian con la versión del detector, el tipo de escritura, la longitud del texto y el corpus, y hay falsos positivos y falsos negativos documentados. Lo mejor es tratar un resultado como una señal y no como una prueba.
Depende de la prueba, y por eso la respuesta útil es una comparación y no una cifra. El benchmark de GPTZero de febrero de 2026 declara una exactitud media del 99,76% con un 0,08% de falsos positivos en cuatro dominios en inglés para el modelo 4.3b. Un estudio independiente de 2024 sobre 1.000 textos académicos midió un 100% de sensibilidad y un 99,6% de especificidad con su propio punto de corte. Un estudio médico preliminar de 2023 declaró un 80% de exactitud y un 65% de sensibilidad en una versión anterior. La misma herramienta, versiones distintas y condiciones distintas.
GPTZero declara una tasa media de falsos positivos del 0,08% en su propio benchmark de febrero de 2026 y del 0,00% en su dominio de ensayos. Los estudios independientes sitúan el riesgo de otra forma según el corpus y el punto de corte, y la documentación de soporte de GPTZero reconoce que la escritura humana puede clasificarse como IA, y por eso desaconseja usar una clasificación como única base para decidir sobre un estudiante.
Sí, en las dos direcciones. La documentación de GPTZero reconoce falsos positivos y falsos negativos, señala que ningún detector es totalmente preciso y afirma que los resultados no deben usarse para castigar a estudiantes. Estudios independientes han medido ambos tipos de error en corpus reales.
Sí. GPTZero reconoce que existen casos límite, y su documentación explica que la exactitud mejora con más texto y que su clasificador está entrenado sobre todo con prosa en inglés escrita por adultos. Los extractos cortos, la escritura formulaica y el texto muy procedimental son los lugares donde un falso positivo es más probable.
Una prosa formal, muy pulida o repetitiva puede parecerse a los patrones que el clasificador asocia con la escritura automática, y una muestra corta le da poco con lo que trabajar. La propia orientación de GPTZero es usar el resultado como un elemento de una valoración más amplia. Si un fragmento es de verdad repetitivo, mejorarlo ayuda; si simplemente es formal, la clasificación dice más de los límites del detector que de tu escritura.
Comprobar con el Detector de IA →Sí. Un falso negativo es texto generado por IA clasificado como humano, y GPTZero afirma que en uso académico prefiere ese error a una acusación falsa. El estudio médico de 2023 midió el coste práctico con una sensibilidad de 0,65 en su corpus. Una edición humana intensa, las herramientas de paráfrasis y los modelos poco conocidos hacen más difícil marcar un fragmento generado.
En el propio benchmark de GPTZero de febrero de 2026, el dominio de ensayos es el más fuerte de los cuatro, con un 100% de exactitud y un 0,00% de falsos positivos para el modelo 4.3b. Es un resultado declarado por la empresa sobre su propio corpus de ensayos, así que describe ese benchmark y no todos los ensayos. Los resultados independientes sobre prosa académica son sólidos pero varían según la versión y el punto de corte usados.
Menos que con textos largos, según la propia GPTZero. Su documentación afirma que la exactitud mejora cuando se envía más texto y que las clasificaciones a nivel de documento son más fiables que las de párrafo, que a su vez lo son más que las de frase. Una frase resaltada por sí sola es una señal débil.
GPTZero está construido para clasificar texto de varias familias de modelos de lenguaje, y el estudio de Acta Neurochirurgica midió puntuaciones medias de probabilidad de IA de GPTZero que subían del 81,71% con GPT-3.5 al 96,83% con GPT-4 y al 99,58% con GPT-4o. Eso no significa que todas las frases de ChatGPT se marquen, ni que una frase marcada demuestre que se usó ChatGPT.
En los corpus citados en esta serie, las métricas declaradas de GPTZero fueron superiores a las de ZeroGPT, incluido un 100% frente a un 94,4% de sensibilidad en el estudio académico de 2024 y un 97,22% frente a un 64,35% de exactitud en un estudio de 2025 sobre resúmenes académicos. Es un resultado sobre esas pruebas y no una clasificación permanente: los productos usan sistemas distintos y los benchmarks, umbrales y versiones cambian. Compara con tu propio texto en lugar de dar un orden por supuesto.
Sí, y es lo esperable. Modelos, datos de entrenamiento y umbrales distintos hacen que dos herramientas puedan leer el mismo fragmento de forma diferente. La propia página de benchmarks de GPTZero recoge las comparaciones que hizo con otros detectores, y los márgenes cambian según el dominio, lo que ilustra bien hasta qué punto el corpus condiciona el resultado.
No como única prueba. La documentación de GPTZero recomienda usar su clasificador como un componente de una valoración más amplia y afirma que los resultados no deben usarse para castigar a estudiantes. Un proceso viable combina la señal de un detector con el historial de redacción, los registros de revisión, las notas de fuentes, trabajos anteriores del mismo estudiante y una conversación sobre el material.
Lee tú mismo los fragmentos marcados, comprueba si la clasificación es a nivel de documento o de frase, mira la categoría de confianza, compara con otro detector y reúne tus borradores y tu historial de versiones. Después revisa solo los fragmentos que de verdad se leen como formulaicos. AI-2-Human puede darte una segunda señal de detección, y el Humanizador puede encargarse de la reescritura si un fragmento realmente la necesita.
Sí. El Detector de AI-2-Human te da otra señal de detección sobre el mismo texto y señala los fragmentos que parecen generados, así que puedes poner dos lecturas una al lado de la otra. Informa de su propia interpretación y no de una copia del modelo de GPTZero, que es lo que hace útil la comparación.
Ejecutar el Detector de IA →Una herramienta de reescritura cambia el texto, y un texto distinto puede clasificarse de otra manera, pero ninguna herramienta puede prometer un resultado concreto: los detectores y los umbrales cambian sin parar, y GPTZero actualiza sus modelos. El enfoque fiable es mejorar la escritura que realmente lo necesita y luego volver a comprobar y comparar. AI-2-Human reescribe fragmentos repetitivos y formulaicos en una versión más natural manteniendo tu sentido.
Humanizar texto de IA →Fuentes y notas editoriales
- GPTZero: tecnología de detección de IA (inglés)
- GPTZero: evaluación de la detección de IA, el estándar del sector en exactitud, transparencia y equidad (inglés)
- GPTZero: ¿cuáles son las limitaciones de su clasificador de IA? (inglés)
- GPTZero: ¿cómo convierto las probabilidades de la API en resultados? (inglés)
- Acta Neurochirurgica: precisión y limitaciones de los detectores de textos de IA (inglés)
- Journal of Korean Medical Science: rendimiento de GPTZero con textos médicos generados por IA, 2023 (inglés)
AI-2-Human no está afiliado a GPTZero ni cuenta con su respaldo. La documentación, la información de benchmark y la investigación citada de GPTZero se consultaron el 20 de septiembre de 2026. Los modelos de detección y su rendimiento pueden cambiar con el tiempo.
Actualizado