Guide sul rilevamento IA
ZeroGPT è affidabile?
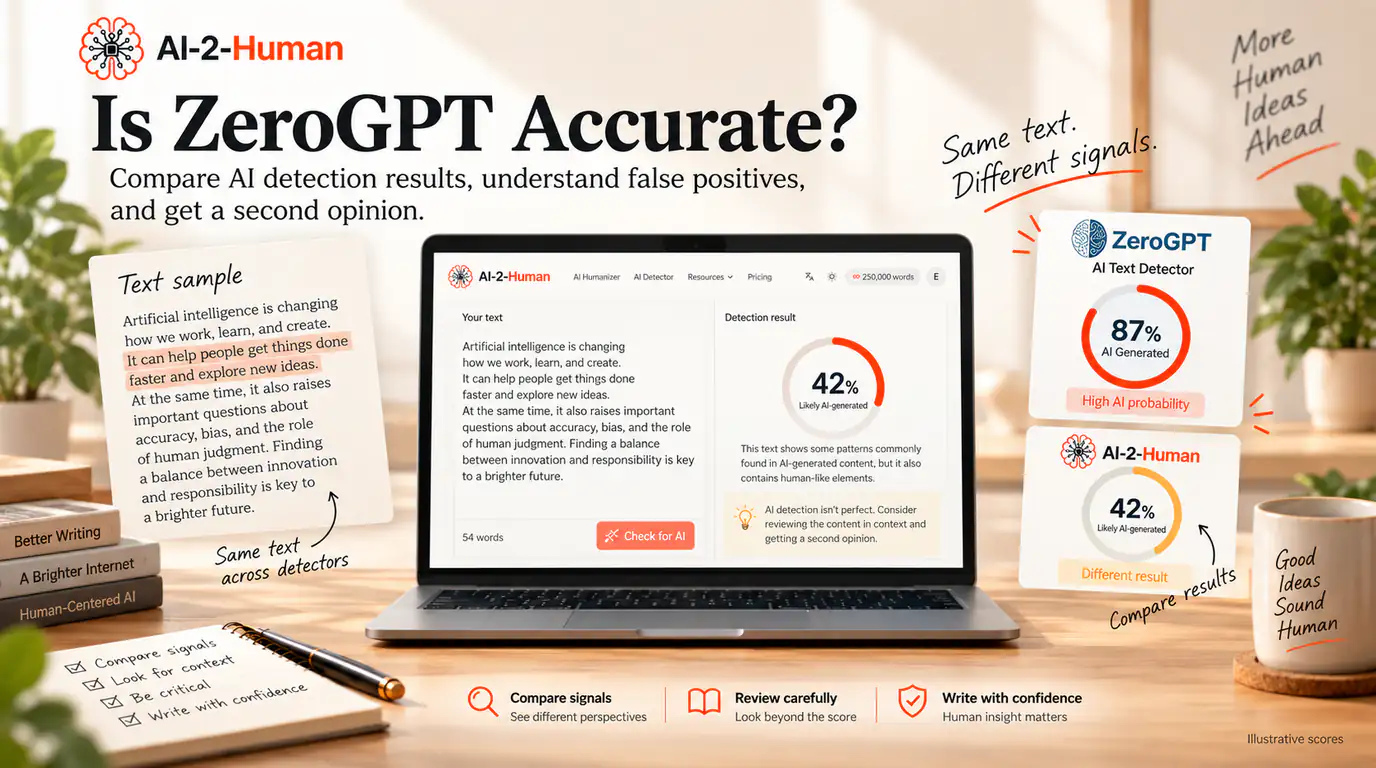
ZeroGPT riesce a separare la scrittura generata dall’IA da quella umana in molti casi, ma non è perfettamente accurato. Gli studi indipendenti che lo hanno testato su dataset accademici e scientifici riportano risultati forti su uno e molto più deboli su un altro, e si verificano sia falsi positivi sia falsi negativi. Un punteggio di ZeroGPT è quindi più utile come segnale da approfondire che come prova di come è stato scritto un passaggio. Se vuoi un secondo parere, puoi far passare lo stesso testo nel rilevatore di AI-2-Human e confrontare ciò che ciascuno strumento evidenzia.
Che cos’è ZeroGPT?
ZeroGPT (zerogpt.com) è un rilevatore di testo IA. Incolli un testo o carichi un file e restituisce un punteggio di probabilità IA per il documento insieme ai passaggi che considera simili a quelli dell’IA. Il rilevatore gratuito accetta fino a 15.000 caratteri per controllo, e l’interfaccia può generare un report in PDF del risultato. Il suo set più ampio di strumenti include un controllo del plagio, un parafrasatore e un humanizer.
La sua documentazione descrive il rilevatore come un sistema che analizza segnali linguistici e statistici appresi da testi umani e IA, tra cui pattern dei token, burstiness, entropia e caratteristiche di un classificatore d’insieme. Ciò che non pubblica sono i pesi addestrati e le soglie di decisione, ed è per questo che il numero va letto come stima di un modello e non come misurazione della paternità.
Quanto è accurato ZeroGPT?
Non esiste una percentuale unica di accuratezza di ZeroGPT valida per ogni tipo di scrittura. Le stime pubblicate vanno da forti a mediocri, e entrambi gli estremi provengono da test legittimi, perché il punteggio di un rilevatore dipende dal dataset, dal genere, dal modello che ha prodotto il testo IA, dalla lunghezza del campione, da quanto è stato modificato, dalla soglia scelta dai ricercatori e da come lo studio definisce la scrittura generata dall’IA.
Le FAQ di ZeroGPT dichiarano l’obiettivo di superare il 98% di accuratezza nelle valutazioni interne, e la homepage pubblicizza il 98,4% di accuratezza di rilevamento con un tasso di falsi positivi inferiore all’1%. Quelle cifre provengono dai test dell’azienda stessa. Team indipendenti che hanno riprovato lo stesso strumento sui propri dataset hanno riportato numeri molto diversi, e sono quelle misurazioni da leggere prima di considerare un punteggio decisivo.
La risposta onesta è quindi un intervallo con condizioni: ZeroGPT ha separato bene la scrittura umana da quella accademica generata da ChatGPT in uno studio su 1.000 testi, e ha reso molto peggio su un altro dataset di abstract scientifici. La sezione successiva mostra le due misurazioni una accanto all’altra.
Che cosa dice la ricerca indipendente su ZeroGPT
Il primo studio, pubblicato su Acta Neurochirurgica nel 2025, ha messo insieme 1.000 testi: 250 abstract e introduzioni scritti da persone, tratti da quattro riviste di neurochirurgia ad alto impatto pubblicate prima di ChatGPT, più 750 versioni dello stesso materiale generate da ChatGPT 3.5, GPT-4 e GPT-4o. Con ZeroGPT il punteggio medio di probabilità IA è stato del 27,55% per i testi umani, dell’81,48% per GPT-3.5, dell’87,39% per GPT-4 e del 94,35% per GPT-4o: una separazione netta tra il gruppo umano e quello generato. Alla soglia scelta dai ricercatori, ZeroGPT ha raggiunto il 94,4% di sensibilità e il 93,2% di specificità, quindi ha individuato gran parte del testo IA e ha correttamente scartato gran parte del testo umano.
Acta Neurochirurgica: accuratezza e limiti dei rilevatori di testi IA
Lo stesso articolo ha misurato GPTZero al 100% di sensibilità e al 99,6% di specificità su quel dataset, cosa che vale la pena sapere per due motivi: mostra che un singolo studio ordina gli strumenti per i propri testi e non in generale, e mostra che anche un rilevatore vicino alla vetta di un benchmark aveva comunque errori nel quadro più ampio descritto dagli autori.
Il secondo studio, pubblicato su PeerJ Computer Science nel 2025, ha confrontato abstract scientifici scritti da persone con abstract generati da ChatGPT o1 e Gemini 2.0 Pro Experimental, poi ha esaminato un secondo scenario in cui quei modelli avevano migliorato il testo originale per renderlo più leggibile. Sul primo dataset ZeroGPT ha raggiunto il 64,35% di accuratezza complessiva, con un tasso di falsi positivi del 16,67% e un tasso di falsi negativi del 45,14%. Il tema dell’articolo è il compromesso tra accuratezza e distorsione: riporta che gli errori non erano distribuiti in modo uniforme, ricadendo in modo sproporzionato su chi scrive in inglese come seconda lingua e su certe discipline.
PeerJ Computer Science: compromessi tra accuratezza e distorsione nel rilevamento di testi IA
Un terzo studio, pubblicato su Advances in Simulation nel 2025, ha confrontato ZeroGPT, PhraslyAI e il rilevatore IA di Grammarly su cinque condizioni di uso dell’IA, da introduzioni umane intatte ad altre sostanzialmente assistite dall’IA, usando 30 articoli pubblicati prima del 2022. I punteggi cambiavano con la condizione, e gli strumenti non concordavano tra loro sullo stesso materiale. Quel disaccordo è la lezione pratica di questa sezione: il numero è una proprietà di un testo, di un modello e di una soglia, non della paternità.
Advances in Simulation: identificare diverse forme di contenuto generato dall’IA
Nessuno di questi articoli ha trovato un rilevatore sempre corretto, compresi gli strumenti che hanno ottenuto i risultati migliori sul proprio dataset.
ZeroGPT può segnalare la scrittura umana come IA?
Sì. Un falso positivo è scrittura umana classificata come generata dall’IA, e la ricerca indipendente lo ha documentato con ZeroGPT. In un piccolo studio esplorativo pubblicato sull’ASEAN Journal of Open and Distance Learning, dieci saggi autentici scritti da studenti universitari filippini sono stati inviati a ZeroGPT e a un secondo rilevatore. Tutti e dieci erano di studenti, e gli strumenti hanno diviso l’insieme a metà: cinque saggi sono stati etichettati come generati dall’IA e cinque come umani. Gli autori descrivono il risultato come un rischio di classificazione errata e sostengono il giudizio umano invece dell’output di un rilevatore come prova.
ASEAN Journal of Open and Distance Learning: falsi positivi nel rilevamento della scrittura IA
Dieci saggi sono un campione piccolo, quindi leggi quello studio come illustrazione del rischio e non come misurazione del tasso di errore di ZeroGPT. Il dataset di PeerJ è l’avvertimento più quantitativo: 16,67% di falsi positivi su abstract scientifici, con un’accuratezza che variava per categoria di autore. Anche le FAQ di ZeroGPT riconoscono il meccanismo, spiegando che una scrittura molto rifinita, schematica o a bassa entropia può somigliare a quella di un’IA, e suggeriscono dettagli concreti, fonti e un ritmo delle frasi vario per ridurre il rischio. La scrittura formale, schematica o in seconda lingua è esattamente dove un rilevatore ha più probabilità di sbagliare.
ZeroGPT può lasciar passare testi generati dall’IA?
Sì, nella direzione opposta. Un falso negativo è testo generato dall’IA classificato come umano, e lo stesso studio di PeerJ ha misurato un tasso di falsi negativi del 45,14% sul suo dataset: quasi la metà degli abstract generati che il test si aspettava di segnalare è tornata come umana. Nel dataset di Acta Neurochirurgica la separazione era molto migliore, con testi umani a una media del 27,55% e testi GPT-3.5 a una media dell’81,48%, ma le medie nascondono la dispersione. I singoli campioni si sovrappongono tra i due gruppi, ed è proprio per questo che un classificatore ha bisogno di una soglia e che quella soglia deve scambiare un tipo di errore con l’altro.
Neanche la scrittura generata dall’IA è una categoria fissa. Un output grezzo di un modello, una bozza leggermente parafrasata e un testo generato e poi riscritto a mano sono oggetti diversi per un classificatore, e lo studio di Advances in Simulation ha mostrato punteggi che cambiavano al variare del grado di coinvolgimento dell’IA. Un punteggio basso quindi non dimostra che un testo sia umano, così come un punteggio alto non dimostra che sia stato scritto da una macchina.
Perché i risultati di ZeroGPT possono variare
Se lo stesso brano riceve punteggi molto diversi in due test, è prevedibile e non un malfunzionamento. Le variabili qui sotto spiegano gran parte del movimento, e sono anche le ragioni per cui un punteggio si trasferisce male da un contesto a un altro.
- Lunghezza del testo: ZeroGPT raccomanda almeno 150-200 parole per una lettura stabile e dichiara che 500-1.000 o più migliorano l’affidabilità. Un paragrafo breve porta poche prove in entrambe le direzioni.
- Genere: la prosa accademica, i testi di marketing, i saggi personali e la documentazione tecnica hanno ritmi diversi, e un modello addestrato su dataset misti li tratta in modo diseguale.
- Modello generatore: GPT-3.5, GPT-4 e GPT-4o scrivono diversamente, e lo studio di Acta Neurochirurgica ha misurato punteggi di probabilità IA via via più alti tra quelle versioni.
- Modifica: un testo generato e poi riscritto a fondo sta tra le due categorie, ed è lì che i rilevatori sono meno stabili.
- Stile umano: la scrittura formale, schematica o in seconda lingua può corrispondere a schemi statistici associati al testo delle macchine, e lo studio di PeerJ ha trovato differenze di accuratezza per categoria di autore.
- Soglia: un classificatore deve scegliere una frontiera di decisione, e spostarla scambia falsi positivi e falsi negativi. ZeroGPT non pubblica la propria soglia.
- Versione del prodotto: i sistemi di rilevamento vengono riaddestrati e aggiornati, quindi un risultato dell’anno scorso può non riprodursi oggi.
Queste variabili sono l’argomento per trattare qualsiasi punteggio isolato come provvisorio e per confrontare un risultato importante con una seconda lettura invece che con il proprio istinto sullo strumento.
Come interpretare un punteggio di ZeroGPT
Una percentuale di ZeroGPT è una stima prodotta da un modello. Non stabilisce paternità, plagio, cattiva condotta né chi ha scritto una frase specifica, e non è mai stata pensata per farlo. Leggila come indicazione: dice dove un modello ha reagito al testo, non che cosa è successo mentre il testo veniva scritto.
Domande che vale la pena porsi prima di agire in base a un punteggio:
- Il testo è abbastanza lungo per una lettura significativa? Sotto le 150 parole un punteggio è una prova debole.
- Quali passaggi sono stati evidenziati e sembrano schematici quando li rileggi?
- Un secondo rilevatore concorda sugli stessi passaggi?
- Ci sono prove del processo di scrittura, come bozze, appunti o una cronologia delle versioni?
- Questo risultato cambierebbe una decisione su una persona? Se sì, chi dovrebbe interpretarlo con te?
ZeroGPT va usato come prova della paternità IA?
No. Il risultato di un rilevatore è una prova tra le altre, e gli studi citati sopra documentano entrambi i tipi di errore su dataset reali. Un’istituzione che tratta un singolo punteggio come prova si espone ad accuse false, e l’articolo di PeerJ mostra che questi errori non sono distribuiti in modo uniforme: chi scrive in inglese come seconda lingua ne portava più di altri, il che peggiora le conseguenze invece di ridurle.
Dove la paternità conta, la prova più solida è il processo di scrittura: bozze, cronologia delle versioni, appunti, citazioni, la capacità di chi ha scritto di parlare del lavoro e la politica che gli si applica. Un rilevatore può indicare passaggi che meritano una conversazione. Non può dirti che cosa è successo, e non gli si dovrebbe chiedere.
Che cosa fare se ZeroGPT segnala il tuo testo
Se il risultato conta, affrontalo con calma invece di riscrivere d’istinto. La maggior parte dei passaggi segnalati ricade in uno di due gruppi: scrittura che ha davvero bisogno di lavoro e scrittura semplicemente formale o prevedibile nello stile. Solo il primo gruppo merita modifiche, e i passaggi seguenti servono a distinguerli.
- 1
Leggi
Leggi tu stesso il passaggio evidenziato e giudicalo come scrittura.
- 2
Confronta
Fai passare lo stesso testo in un secondo rilevatore e confronta.
- 3
Esamina
Cerca forme di frase ripetute, transizioni vuote e affermazioni vaghe.
- 4
Verifica
Controlla argomentazione, fatti e citazioni separatamente.
- 5
Prove
Raccogli bozze e cronologia delle versioni quando la paternità è contestata.
- 6
Rivedi
Riscrivi solo i passaggi che hanno davvero bisogno di migliorare.
A volte la segnalazione indica una debolezza reale: paragrafi costruiti su un’unica forma di frase, transizioni che non collegano nulla, affermazioni senza alcun esempio dietro. Quando è così, l’Humanizer di AI-2-Human può riscrivere il passaggio ripetitivo o schematico in una versione più naturale mantenendo il significato centrale, e poi modifichi il risultato con la tua voce.
Dovresti confrontare ZeroGPT con un altro rilevatore IA?
Sì, soprattutto quando il risultato ha conseguenze. I rilevatori usano modelli diversi, dati di addestramento diversi e soglie diverse, quindi il disaccordo tra due è normale e non prova che uno sia rotto. Questa pagina ne è l’esempio: lo stesso strumento ha ottenuto punteggi molto diversi tra dataset, e strumenti diversi si sono classificati in modo diverso all’interno di uno stesso dataset.
Il confronto aiuta in entrambe le direzioni. Se due rilevatori evidenziano lo stesso passaggio, quel passaggio merita una lettura attenta. Se divergono nettamente, la divergenza dice che il testo è vicino a una soglia di decisione e che il numero è morbido: è utile saperlo prima di riscrivere qualcosa o prima che qualcun altro agisca in base a quel numero.
Il rilevatore di AI-2-Human comunica la propria lettura del testo e indica i passaggi che sembrano ancora generati, così puoi mettere due interpretazioni accanto prima di decidere che cosa cambiare.
Prima di consegnare: una checklist pratica
- Tratto il risultato di ZeroGPT come un segnale e non come una prova.
- Ho letto i passaggi che hanno destato preoccupazione.
- Ho considerato la lunghezza e il tipo di testo controllato.
- Ho confrontato il risultato con un altro rilevatore perché l’esito conta.
- Ho controllato se la scrittura è davvero ripetitiva o schematica.
- Ho conservato bozze o cronologia delle versioni dove la paternità potrebbe essere contestata.
- Ho verificato fatti e citazioni separatamente dal rilevamento IA.
- Ho rivisto solo i passaggi che avevano davvero bisogno di migliorare.
Domande frequenti
ZeroGPT riesce a distinguere efficacemente testo generato dall’IA e testo umano in alcuni dataset, ma l’accuratezza non è costante su ogni tipo di scrittura. Studi indipendenti hanno riportato prestazioni forti in un test accademico e decisamente più deboli in un altro. Falsi positivi e falsi negativi sono entrambi possibili, quindi il risultato va trattato come un segnale e non come prova definitiva.
Non esiste una cifra unica. In uno studio accademico su 1.000 testi pubblicato su Acta Neurochirurgica, ZeroGPT ha raggiunto il 94,4% di sensibilità e il 93,2% di specificità alla soglia scelta dai ricercatori. In uno studio di PeerJ Computer Science su abstract scientifici ha raggiunto il 64,35% di accuratezza con il 16,67% di falsi positivi e il 45,14% di falsi negativi. Entrambe sono misurazioni reali su dataset diversi, ed è per questo che l’affermazione di oltre il 98% di ZeroGPT descrive le sue valutazioni interne e non un risultato universale.
Sì. La ricerca indipendente documenta entrambi i tipi di errore: scrittura umana classificata come IA e scrittura generata dall’IA classificata come umana. Il tasso dipende dal dataset, dal genere, dal modello generatore, dalla lunghezza del testo e dalla soglia usata, quindi nessun risultato isolato va considerato definitivo.
Sì. Un piccolo studio esplorativo su dieci saggi autentici di studenti ha rilevato che ZeroGPT e un secondo rilevatore ne etichettavano cinque come generati dall’IA e cinque come umani, benché tutti e dieci fossero di studenti. Uno studio più ampio su abstract scientifici ha misurato un 16,67% di falsi positivi, con più errori per chi scrive in inglese come seconda lingua e per certe discipline.
Una scrittura formale, molto rifinita o ripetitiva può somigliare agli schemi che un rilevatore associa al testo delle macchine, e i campioni brevi gli danno poco su cui lavorare. La documentazione di ZeroGPT dice lo stesso e suggerisce di aggiungere dettagli concreti, fonti e un ritmo delle frasi vario. Se un passaggio è davvero schematico, riscriverlo aiuta; se è soltanto formale, il punteggio dice più del rilevatore che della scrittura.
Sì. Uno studio indipendente ha misurato un tasso di falsi negativi del 45,14% sul suo dataset di abstract scientifici, e la prestazione di un rilevatore cambia anche con il modello che ha prodotto il testo, con le istruzioni date e con quanto è stato modificato in seguito. Un punteggio IA basso non dimostra che un testo sia stato scritto da una persona.
ZeroGPT dichiara di rivolgersi a diverse famiglie di modelli linguistici e non solo a ChatGPT, e lo studio di Acta Neurochirurgica ha trovato punteggi di probabilità IA via via più alti per gli output di GPT-3.5, GPT-4 e GPT-4o. Questo non significa che ogni passaggio di ChatGPT venga segnalato, né che un passaggio segnalato provi che è stato usato ChatGPT.
Nei due dataset citati in questa pagina le metriche riportate di GPTZero erano superiori a quelle di ZeroGPT: 100% contro 94,4% di sensibilità nello studio di Acta Neurochirurgica, e 97,22% contro 64,35% di accuratezza nello studio di PeerJ. È un risultato su quei test e non una classifica universale: dataset, soglie e versioni dei prodotti cambiano, e entrambi gli strumenti hanno comunque prodotto errori. Conviene confrontare sul proprio testo invece di dare per scontato un ordine.
Sì, e spesso lo fanno. Modelli, dati di addestramento e soglie di decisione diversi fanno sì che lo stesso passaggio possa essere letto in modo differente da due strumenti. Lo studio di Advances in Simulation ha confrontato tre rilevatori su cinque condizioni di uso dell’IA e ha rilevato che i punteggi cambiavano con la condizione e che gli strumenti non concordavano tra loro.
Non come unica prova. I tassi di falsi positivi documentati, e il fatto che gli errori ricadano in modo diseguale su chi scrive in inglese come seconda lingua, suggeriscono di trattare il risultato di un rilevatore come punto di partenza di una conversazione sul lavoro. Bozze, cronologia delle versioni, appunti e la capacità dello studente di parlare del materiale pesano più di qualsiasi punteggio isolato.
Leggi tu stesso i passaggi evidenziati, confronta il risultato con un altro rilevatore, esamina la scrittura cercando forme di frase ripetute e transizioni vuote, verifica fatti e citazioni e conserva le tue bozze. Rivedi i passaggi che si leggono davvero come schematici invece di riscrivere un testo già chiaro. AI-2-Human può occuparsi del passaggio di riscrittura e darti un secondo segnale di rilevamento.
Sì, quando l’esito conta. Una seconda lettura ti dice se un risultato è stabile tra strumenti o se dipende da quello che ti è capitato di usare. Dove entrambi i rilevatori evidenziano lo stesso passaggio, quel passaggio merita una revisione; dove divergono nettamente, il punteggio è morbido e non dovrebbe decidere nulla da solo.
Controlla con il rilevatore IA →Sì. Il rilevatore di AI-2-Human offre un altro segnale di rilevamento sullo stesso testo e indica i passaggi che sembrano generati, così puoi confrontare due interpretazioni prima di decidere che cosa cambiare. Comunica la propria lettura e non una copia del modello di ZeroGPT.
Avvia il rilevatore IA →Uno strumento di riscrittura cambia il testo, e un testo diverso può essere valutato diversamente, ma nessuno può promettere un numero specifico: rilevatori e soglie cambiano di continuo. Per questo l’approccio utile è migliorare la scrittura che ne ha davvero bisogno, poi controllare di nuovo e confrontare. AI-2-Human riscrive passaggi ripetitivi e schematici in una versione più naturale mantenendo il tuo significato.
Umanizza testo IA →Fonti e note editoriali
- ZeroGPT: rilevatore IA (in inglese)
- ZeroGPT: domande frequenti (in inglese)
- Acta Neurochirurgica: accuratezza e limiti dei rilevatori di testi IA (in inglese)
- PeerJ Computer Science: compromessi tra accuratezza e distorsione nel rilevamento di testi IA (in inglese)
- Advances in Simulation: identificare diverse forme di contenuto generato dall’IA (in inglese)
- ASEAN Journal of Open and Distance Learning: falsi positivi nel rilevamento della scrittura IA (in inglese)
AI-2-Human non è affiliata a ZeroGPT né sostenuta da ZeroGPT. Le informazioni sul prodotto ZeroGPT e la ricerca citata sono state consultate il 20 settembre 2026. Il comportamento dei rilevatori e le funzionalità dei prodotti possono cambiare nel tempo.
Aggiornato