Ratgeber zur KI-Erkennung
Ist der KI-Detektor von Grammarly zuverlässig?
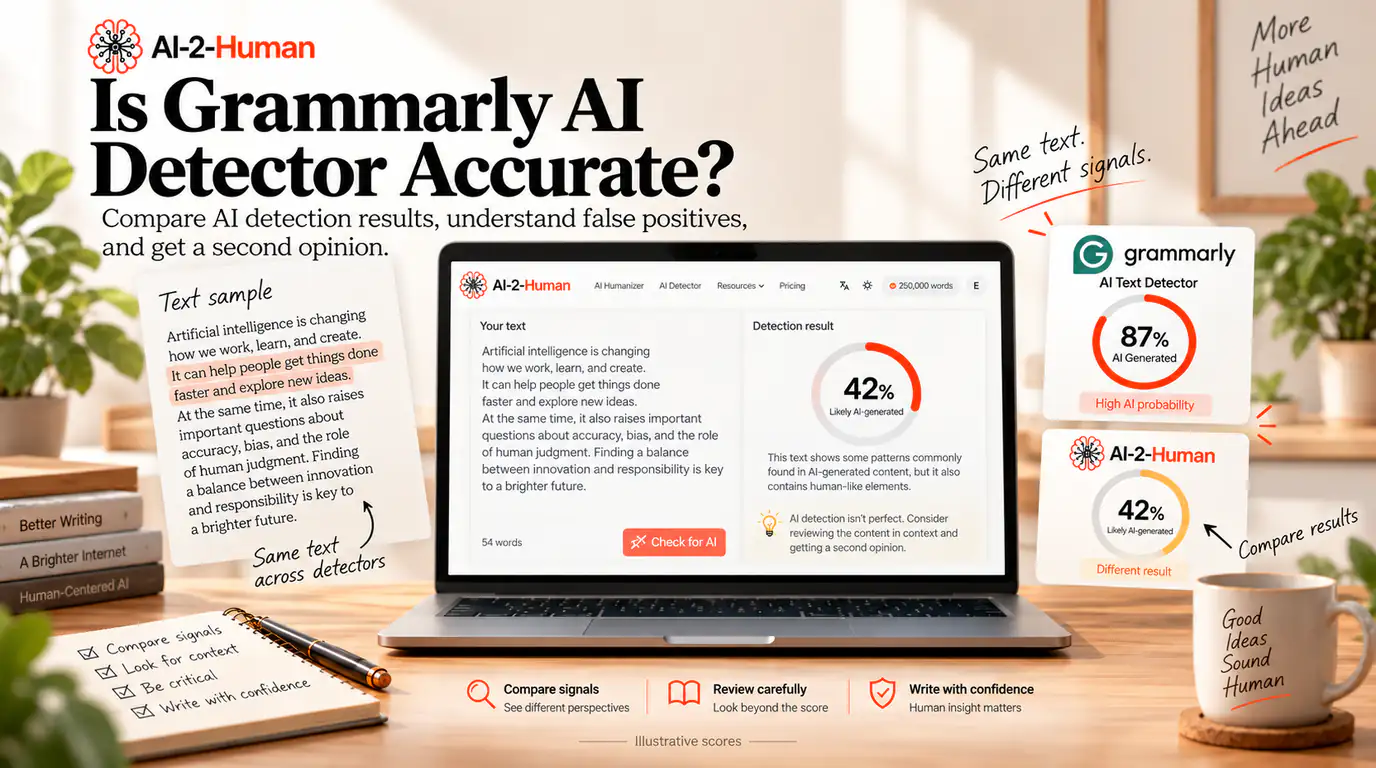
Der KI-Detektor von Grammarly kann in standardisierten Benchmarks sehr stark abschneiden, doch sein Wert beweist nicht, wie ein Dokument entstanden ist. Grammarly nennt die Prozentzahl eine gemittelte Schätzung, erklärt die Funktion für nicht 100% genau und weist darauf hin, dass kurze Abschnitte schwerer zu messen sind. Die unabhängige Evidenz zeigt in dieselbe Richtung: starke Werte in einem großen geteilten Benchmark, während eine akademische Studie von 2025 auf denselben KI-geschriebenen Einleitungen viel niedrigere Prozentzahlen als ein anderer Detektor verzeichnete. Ein Grammarly-Wert ist also ein Signal. Wenn das Ergebnis zählt, prüfe denselben Abschnitt mit einem zweiten Detektor und lies den markierten Text selbst. Der KI-Detektor von AI-2-Human liefert dir diese zweite Lesart.
Was ist der KI-Detektor von Grammarly?
Der KI-Detektor von Grammarly schätzt, welcher Teil eines Textes KI-generiert wirkt. Grammarly erklärt den Mechanismus selbst: Der Text wird in Abschnitte zerlegt, jeder Abschnitt wird gegen ein Modell für maschinelles Lernen geprüft, das nach typischen KI-Mustern sucht, etwa Sprachmuster, Syntax und Komplexität, und danach gibt Grammarly eine Prozentzahl zurück. Das Modell sei mit Hunderttausenden menschlichen und KI-geschriebenen Texten trainiert.
Die Funktion ist keine separate Website für einen einmaligen Besuch. Grammarly integriert sie ins Produkt: den AI Detector in seinen Schreiboberflächen, die KI-Prüfung in Google Docs über die Browser-Erweiterung und die Desktop-Apps für Word, und in den meisten Tarifen ist sie kostenpflichtig. Eine kostenlose Version läuft auf der öffentlichen AI-Detector-Seite, wo du Text einfügst oder ein Dokument hochlädst.
Wie genau ist der KI-Detektor von Grammarly nun?
Es gibt keine einzelne Genauigkeitszahl, die jede Grammarly-Prüfung beschreibt. Sagbar ist etwas Engeres: Der Detektor trennt KI-Text und menschlichen Text unter Benchmark-Bedingungen sehr zuverlässig, und unabhängige Forschung zeigt, dass die zurückgegebenen Prozentzahlen deutlich unter dem tatsächlichen KI-Anteil liegen können.
Grammarlys eigene Formulierungen setzen die Erwartung besser als jede Zusammenfassung. Das Nutzerhandbuch nennt den Wert eine gemittelte Schätzung, wie viel KI-generierter Text ein Dokument wahrscheinlich enthält, sagt, Tests hätten die Richtungstreue des Modells sichergestellt, weist darauf hin, dass kürzere Abschnitte schwerer zu messen sind, und erklärt, die Funktion sei nicht 100% genau und dürfe nicht als abschließende Bewertung gelten. Ein weiterer Hilfeartikel ergänzt, kein Detektor könne heute abschließend feststellen, ob KI genutzt wurde, und diese Tools seien ein einzelner Datenpunkt, nicht die einzige Evidenzquelle.
Grammarly: Löst die Nutzung von Grammarly KI-Detektoren aus? (auf Englisch)
- Schreibstil: formale, sehr gleichmäßige Prosa liegt näher an den Mustern, die Detektoren mit Maschinenschreiben verbinden.
- Textlänge: kürzere Abschnitte sind schwerer zu messen als längere, so Grammarly selbst.
- Modell: verschiedene Sprachmodelle hinterlassen verschiedene Spuren, und Detektoren sind auf bestimmte Familien abgestimmt.
- Menschliche Bearbeitung: KI-generierter und dann stark umgeschriebener Text wirkt nicht mehr wie rohe Modellausgabe.
- Gemischte Autorschaft: menschliche Entwürfe, KI-Hilfe und manuelle Überarbeitung zusammen sind der schwerste Fall.
- Version und Datensatz: Grammarly aktualisiert das Modell, und jede Zahl hängt von Genre und Länge des Testmaterials ab.
Was bedeutet die Prozentzahl von Grammarly wirklich?
Ein Wert von 40% heißt nicht, dass Grammarly festgestellt hat, dass genau 40% des Dokuments von KI stammen. Es heißt, dass das Modell in den geprüften Abschnitten Muster fand, die diesen Anteil des Textes wie KI-Schreiben wirken lassen. Grammarly verwendet die Wörter Schätzung und gemittelt bewusst und wiederholt die Einschränkung: Der Wert sei eine gemittelte Schätzung und keine abschließende Prozentbewertung und dürfe nicht als objektive Wahrheit gelten, weil KI-Erkennung jeder Art fehleranfällig ist.
Das abschnittsweise Design erklärt einen Teil der Unschärfe. Die Zerlegung zeigt, welche Teile das Ergebnis verursacht haben, doch eine Prozentzahl presst mehrere lokale Urteile in eine einzige Zahl: Ein Dokument mit drei formelhaften und vier persönlichen Absätzen kann auf einem mittleren Wert landen, der keine der beiden Hälften gut beschreibt.
Was der RAID-Benchmark über Grammarly berichtet
RAID ist ein geteilter Benchmark, der Detektoren unter gleichen Bedingungen bewertet: über 10 Millionen Dokumente mit 11 Sprachmodellen, 11 Genres, vier Dekodierungsstrategien und adversarialen Angriffen wie Paraphrasieren, Synonymtausch und Homoglyphen. Jeder teilnehmende Detektor wird mit demselben Material und demselben Auswertungsskript bewertet, was RAID zum fairsten öffentlichen Vergleich macht und zugleich zu dem, der sich am schwersten in ein Versprechen über einen einzelnen Aufsatz verwandeln lässt.
Grammarly bewirbt seine Leistung in diesem Benchmark direkt. Die Produktseite des Detektors erklärt, das Produkt erreiche 99% Erkennungsgenauigkeit und stehe im unabhängigen RAID-Benchmark an erster Stelle, vor anderen führenden KI-Detektoren. Das ist eine Anbieteraussage des Unternehmens, dessen Detektor beschrieben wird, und sollte auch so gelesen werden.
Grammarly: Produktseite des KI-Detektors (auf Englisch)
Das Leaderboard selbst ist konkreter. Der hier zitierte Stand wurde am 20. September 2026 erfasst, der Grammarly-Eintrag ist auf den 9. Februar 2026 datiert. Einträge werden von den Detektor-Entwicklern eingereicht und mit dem Skript des Benchmarks bewertet, die Bedingungen sind also geteilt, die Einreichung kommt vom Anbieter. In diesem Stand nennt Grammarly einen AUROC von 0,9987 über alle RAID-Bedingungen inklusive adversarischer Angriffe, mit 99,47% Genauigkeit bei einer Zielquote falscher Treffer von 5% und 98,21% bei 1%. Im nicht-adversarischen Teil meldet derselbe Eintrag einen AUROC von 0,99972 und 99,91% Genauigkeit bei 5%.
Die Metriknamen sind wichtig. Der AUROC misst, wie gut ein Detektor die beiden Klassen über alle Schwellen hinweg trennt, wobei 1,0 perfekt ist, und ist kein Prozentwert richtiger Entscheidungen. RAID misst Genauigkeit an einem festen Betriebspunkt, der Schwelle, an der nur 5% oder 1% der menschlichen Texte falsch markiert werden.
Was unabhängige Forschung über Grammarly sagt
Das nützlichste unabhängige Ergebnis stammt aus einer begutachteten Studie, die 2025 in Advances in Simulation erschien. Die Forschenden nahmen 30 vor 2022 erschienene Open-Access-Artikel aus zwei Fachzeitschriften für Simulation im Gesundheitswesen, entnahmen die Einleitungen und erstellten fünf Versionen je Text: das menschliche Original, eine leicht KI-bearbeitete Fassung, eine stark KI-bearbeitete, eine aus menschlichen Stichpunkten generierte und eine vollständig aus dem Titel geschriebene. Drei kostenlose Detektoren (ZeroGPT, Phrasly AI und Grammarly) und fünf verblindete menschliche Bewerter bewerteten dasselbe Material.
Grammarly unterschied die fünf Bedingungen insgesamt, mit statistisch signifikantem Effekt und einer Effektstärke von 0,75, doch seine absoluten Prozentzahlen lagen weit unter dem KI-Anteil im Text. Auf denselben Einleitungen lag der Durchschnitt bei 1,6% für unberührten menschlichen Text (95%-Konfidenzintervall 0,0 bis 3,1), 3,0% bei leichter KI-Bearbeitung, 11,5% bei starker, 62,5% bei aus Stichpunkten generiertem Text und 50,0% bei vollständig aus dem Titel erzeugtem Text. ZeroGPT lag bei 6,5%, 20,2%, 43,1%, 89,9% und 92,5%.
Daraus folgen zwei Schlüsse in entgegengesetzte Richtungen. Der ermutigende: Die Reihenfolge stimmte, die Werte stiegen mit dem KI-Anteil, und Grammarly markierte am seltensten unberührten menschlichen Text. Der mahnende: Ein vollständig von einem Sprachmodell geschriebenes Dokument kam im Mittel mit 50% zurück, weit entfernt von dem, was Lesende maschinengeschrieben nennen würden.
Die Studie maß auch die Übereinstimmung der Tools. ZeroGPT und Phrasly stimmten mit 0,96 sehr gut überein. Grammarly und ZeroGPT nur mäßig, mit 0,60 und einem Bias von 24,7 Punkten: ZeroGPT gab auf demselben Material systematisch höhere KI-Werte zurück, Phrasly gegen Grammarly lag bei 0,57. Die menschlichen Bewerter waren nicht besser, ihre Gesamtgenauigkeit lag bei 19%.
Kann Grammarly menschlichen Text als KI markieren?
Ja. Ein falscher Treffer ist wirklich menschlicher Text, den ein Detektor als KI-generiert oder KI-gestützt liest, und Grammarly räumt den Fall ein. Die Dokumentation erklärt, das Modell sei darauf optimiert, falsche Treffer zu minimieren, es könne Fälle geben, in denen menschliche Sprachmuster, Syntax und Komplexität KI-Text ähneln, und solche Fälle sollten sehr selten sein. Danach folgt derselbe Rat wie in dieser Übersicht: das Ergebnis im weiteren Kontext lesen, nicht als objektive Wahrheit.
Die Risikofaktoren werden in der Detektorliteratur einheitlich beschrieben, und es sind Eigenschaften des Textes, keine Liste von Grammarly. Sehr formales Register, gleichförmiger Satzbau, vorhersehbare Übergänge, geringe Wortvielfalt, sehr kurze Proben, Genres fernab der Trainingsdaten und Englisch als Zweitsprache liegen näher an der Grenze. Nichts davon belegt KI-Nutzung, und einiges davon entsteht durch sorgfältiges Schreiben.
Kann Grammarly KI-generierten Text übersehen?
Ja, und die Studie von 2025 ist das konkreteste öffentliche Beispiel: Vollständig aus dem Titel KI-generierter Text lag im Mittel bei 50,0% auf Grammarly, während dasselbe Material auf den anderen beiden Tools über 92% erreichte. Daraus lässt sich keine Ausfallquote ableiten, denn die Zahl beschreibt 30 Einleitungen einer Disziplin, mit einer Modellfamilie und zu einem Zeitpunkt. Sie zeigt aber die Form des Problems: Ein auf wenige falsche Treffer optimierter Detektor lässt einen Teil maschinengeschriebenen Textes durch.
Die Dokumentation erklärt, warum eine Überarbeitung durchrutschen kann. Das Modell wird mit menschlichem und KI-generiertem Text von Modellanbietern trainiert, Grammatik- oder Klarheitsvorschläge ändern die Prozentzahl meist nicht, bedeutendes Umschreiben mit einem generativen Modell erhöht sie. Von Hand bearbeiteter KI-Text liegt dazwischen, ebenso ein menschlicher Absatz, den ein Assistent stark umgeschrieben hat, also der Fall gemischter Autorschaft, den kein Detektor sauber löst. Neuere Modelle machen das Problem größer, weil Detektoren gegen die Ausgaben trainiert werden, die es beim Bau des Modells gab.
Warum Grammarly-Ergebnisse schwanken können
Wenn zwei Personen denselben Text durch dasselbe Tool schicken und verschiedene Zahlen erhalten, oder wenn zwei Tools sich über ein Dokument uneinig sind, liegt die Erklärung meist in den Bedingungen.
- Detektorversion: Grammarly aktualisiert sein Modell laufend, Ergebnisse verändern sich mit dem Produkt.
- Länge und Granularität: Der Text wird abschnittsweise geprüft, ein kurzes Dokument beruht auf weniger lokalen Entscheidungen.
- Bearbeitungshistorie: Grammatik- und Klarheitskorrekturen lassen den Wert meist unverändert, generatives Umschreiben erhöht ihn.
- Schwelle und Vergleich: Wo ein Detektor die Grenze zieht, ist wichtig, und Grammarly sagt, seine Werte wichen von Turnitin, GPTZero, Copyleaks und anderen ab.
Eine Prozentzahl ist nur zusammen mit einer Beschreibung des Textes lesbar. Zwei Sätze aus einem Absatz, ein in einem Zug geschriebener Aufsatz und ein über drei Wochen mit einem Assistenten erstellter Bericht sind drei verschiedene Messungen, auch wenn das Tool denselben Wertetyp ausgibt.
Beeinflusst die Textlänge den Grammarly-Wert?
Grammarly sagt es direkt: Kürzere Abschnitte sind schwerer genau zu messen als längere. Das ist eine vernünftige Aussage über Evidenz, denn ein abschnittsweise arbeitender Detektor hat bei zwei Sätzen weniger Abschnitte als Grundlage.
Die praktische Regel ist Verhältnismäßigkeit. Ein hoher Wert über ein ganzes Dokument, in dem sich Muster über mehrere Absätze wiederholen, verdient mehr Aufmerksamkeit als ein hoher Wert auf einem einzelnen markierten Satz. Bei kurzen Proben bleibt das Ergebnis vorläufig.
Ändern Bearbeiten oder Paraphrasieren den Grammarly-Wert?
Grammarly zieht eine Linie innerhalb der Bearbeitung, und sie ist nützlich. Traditionelle, nicht generative Korrekturen wie Vorschläge zu Grammatik, Klarheit, Wortwahl und Prägnanz ändern die KI-Prozentzahl meist nicht, weil sie die zugrunde liegenden Sprachmuster nicht verändern. Sätze oder ganze Absätze mit einem generativen Assistenten umzuschreiben ist etwas anderes: Grammarly erklärt, bedeutendes Umschreiben mit seinem Agenten, Assistenten oder einem Paraphrasierer erhöhe den Wert, und Text von einem externen Anbieter werde noch wahrscheinlicher höher eingestuft.
Das Unternehmen wendet diese Logik auf die eigenen Tools an, was ungewöhnlich offen ist. Die Dokumentation warnt, dass Umschreiben mit Grammarlys Umformulierungs- oder Humanisierungsagenten das Ergebnis wahrscheinlich als KI-generiert markiert, weil diese Umschreibungen aus Grammarlys eigenem Sprachmodell stammen, und empfiehlt, Agenten für Feedback zu nutzen, das man manuell einarbeitet, wenn eine Markierung problematisch ist. Liest man den Wert einer anderen Person, gilt dasselbe umgekehrt: Text, der durch einen Paraphrasierer gelaufen ist, ist schwerer zu deuten, und ein niedriger Wert beweist nicht, dass kein Assistent beteiligt war.
KI-Detektor von Grammarly oder Authorship?
Grammarly liefert zwei verschiedene Ideen unter ähnlichen Namen, und ihre Verwechslung führt am schnellsten zu einer Fehldeutung. KI-Erkennung untersucht den fertigen Text und schätzt, wie viel davon KI-Schreiben ähnelt. Authorship zeichnet auf, wie das Dokument entstand, und ordnet Text beim Eintragen ein: direkt geschrieben, aus einer Browserquelle eingefügt, aus unbekannter Quelle wie einem privaten Fenster eingefügt, von KI generiert oder geschrieben und anschließend mit KI-Umformulierung verändert.
Grammarly: Einführung in Authorship (auf Englisch)
Authorship funktioniert in Google Docs über die Browser-Erweiterung und in Word über die Desktop-App und erzeugt teilbare Berichte, die in höheren Tarifen KI- und Plagiatsprüfungen enthalten können. Die entscheidende Unterscheidung ist einfach: Ein Detektor liest den Text und schätzt, ein Autorschaftsprotokoll beschreibt den Entstehungsprozess.
Wie man einen Grammarly-Wert interpretiert
Bevor du auf eine Prozentzahl reagierst, gehe diese Fragen durch. Sie sind der Unterschied zwischen einem Signal und einem Urteil.
- Wie viel Text wurde geprüft: ein ganzes Dokument oder ein kurzer Auszug?
- Ist der Abschnitt stark bearbeitet, KI-gestützt oder gemischt?
- Welche Abschnitte wurden markiert, und teilen sie ein Muster?
- Wirkt der Text wirklich repetitiv oder formelhaft?
- Liefert ein zweiter Detektor eine ähnliche Lesart?
- Gibt es Entwürfe, Versionsverlauf oder einen Authorship-Bericht?
Was ein Grammarly-Wert allein nicht belegen kann, sollte klar gesagt werden. Er sagt nicht, wer ein Dokument geschrieben hat, ob eine KI-Nutzung gegen Regeln verstieß, ob plagiiert wurde oder ob jemand ehrlich ist. Grammarly beschreibt seine Erkennung selbst als einzelnen Datenpunkt, nicht als einzige Evidenzquelle.
Was tun, wenn Grammarly deinen Text markiert?
Arbeite die Situation in fester Reihenfolge ab, statt reflexhaft umzuschreiben. Es ist dieselbe Sequenz, die diese Übersicht für jeden Detektor empfiehlt.
- 1
Den markierten Abschnitt lesen
Beurteile ihn zuerst als Text: Wirkt er wirklich repetitiv oder formelhaft?
- 2
Die Stichprobengröße prüfen
Kam der Wert aus einem ganzen Dokument oder aus zwei Sätzen?
- 3
Einen zweiten Detektor vergleichen
Schicke denselben Text durch ein anderes Tool und prüfe, ob die Lesarten übereinstimmen.
- 4
Prozessbelege sammeln
Suche Entwürfe, Versionsverlauf oder einen Authorship-Bericht.
- 5
Überarbeiten, was es braucht
Schreibe nur die Abschnitte um, die es brauchen, und prüfe Belege separat.
Manchmal ist die Sorge berechtigt. Gleichförmige Sätze, Übergänge, die nichts verbinden, und Absätze ohne Belege sollten korrigiert werden, ob ein Detektor sie bemerkt hat oder nicht. Ist ein Abschnitt wirklich mechanisch, schreibt der Humanizer von AI-2-Human eine natürlichere Fassung, die deine Bedeutung bewahrt.
Solltest du Grammarly mit einem anderen Detektor vergleichen?
Ja, und die Empfehlung kommt hier ebenfalls vom Anbieter. Die Dokumentation erklärt, die Erkennung nutze ein eigenes Inhouse-Modell, Werte könnten von anderen Lösungen wie Turnitin, GPTZero oder Copyleaks abweichen, und der Wert sei kein klarer Hinweis darauf, dass ein anderer Detektor dasselbe meldet. Die unabhängige Studie maß denselben Effekt: 0,60 Übereinstimmung zwischen Grammarly und ZeroGPT auf identischen Texten, mit rund 25 Punkten Unterschied.
Der Vergleich hilft in beide Richtungen. Markieren zwei Detektoren dieselbe Stelle, verdient sie eine genaue Lektüre. Widersprechen sie sich deutlich, liegt der Text nahe an einer Entscheidungsgrenze und der Wert ist weich, was man vor einer Überarbeitung wissen sollte.
Der AI-2-Human Detektor liest denselben Abschnitt mit seinem eigenen Modell und zeigt die Stellen, die noch generiert wirken, sodass zwei Interpretationen nebeneinander stehen. Das ist eine zweite Meinung, keine höhere Instanz: Du bekommst mehr Grundlagen, bevor du entscheidest, ob und was geändert wird.
Vor der Abgabe: eine praktische Checkliste
- Ich weiß, dass der Grammarly-Wert eine Schätzung und keine Messung ist.
- Ich habe geprüft, wie viel Text analysiert wurde, bevor ich den Wert lese.
- Ich habe die markierten Stellen gelesen und nicht nur die Schlagzahl.
- Ich habe bedacht, ob der Text menschlich, KI-gestützt oder gemischt ist.
- Ich habe einen zweiten Detektor verglichen, wenn das Ergebnis zählt.
- Ich habe nach Entwürfen, Versionsverlauf oder einem Authorship-Bericht gesucht.
- Ich habe Belege und Fakten getrennt von der KI-Erkennung geprüft.
- Ich habe nur die Abschnitte überarbeitet, die es wirklich brauchten.
Häufige Fragen
Grammarlys Detektor schneidet in standardisierten Benchmarks stark ab: Der eigene RAID-Eintrag nennt einen AUROC von 0,9987 und 99,47% Genauigkeit bei einer Zielquote falscher Treffer von 5% im geprüften Stand. Kein Detektor ist für jeden Text genau. Grammarly nennt seinen Wert eine Schätzung und keinen Beweis für KI-Nutzung, und unabhängige Forschung zeigt, dass die Werte deutlich unter dem tatsächlichen KI-Anteil liegen können.
Die ehrliche Antwort: Es kommt auf den Test an, deshalb unterscheiden sich veröffentlichte Zahlen so stark. In RAID, einem großen geteilten Benchmark mit adversarialen Angriffen, meldet der Grammarly-Eintrag einen AUROC von 0,9987. In einer unabhängigen Studie von 2025 mit 30 Artikeleinleitungen ordnete Grammarly die fünf Schreibbedingungen korrekt ein, lag aber im Mittel bei 50,0% für vollständig KI-generierten Text, gegenüber 92,5% für ZeroGPT auf demselben Material.
Sie ist Grammarlys gemittelte Schätzung, welcher Teil des geprüften Textes KI-generiert wirkt. Grammarly zerlegt das Dokument in Abschnitte, prüft jeden auf typische KI-Muster wie Sprachmuster, Syntax und Komplexität und gibt eine Prozentzahl zurück. Ein Wert von 40% heißt nicht, dass 40% des Dokuments nachweislich maschinengeschrieben sind.
Nein, und Grammarly sagt das in der eigenen Dokumentation. Die Funktion sei nicht 100% genau, dürfe nicht als abschließende Bewertung gelten und der Wert sei keine objektive Wahrheit, weil KI-Erkennung jeder Art fehleranfällig ist.
Ja. Grammarly räumt die Möglichkeit ein und erwartet, dass solche Fälle sehr selten sind, weist aber darauf hin, dass menschliche Sprachmuster, Syntax und Komplexität KI-Text ähneln können. Formales Register, repetitiver Satzbau, sehr kurze Proben und ungewöhnliche Genres sind die wahrscheinlichsten Situationen, und eine Markierung ist kein Beweis für KI-Nutzung.
Meist weil Teile des Textes oberflächliche Merkmale mit Maschinenschreiben teilen, nicht weil etwas Unzulässiges passiert ist. Grammarly prüft abschnittsweise, ein paar formelhafte Absätze heben den Wert, und kurze Passagen geben dem Modell weniger Grundlage. Vergleiche einen zweiten Detektor und lies die markierten Stellen selbst.
Mit dem KI-Detektor prüfen →Ja. Die Studie von 2025 in Advances in Simulation verzeichnete im Mittel 50,0% für Grammarly bei Einleitungen, die vollständig aus dem Titel KI-generiert waren, deutlich niedriger als die anderen Detektoren. Grammarly erklärt zudem, das Modell sei auf wenige falsche Treffer optimiert, also bewusst zurückhaltend, wenn es menschliches Schreiben beschuldigt, und zurückhaltende Modelle lassen mehr Maschinenschreiben durch.
Grammarly sagt, sein Detektor erkenne Text, der von großen Modellen geschrieben oder verändert wurde, darunter ChatGPT, Claude und Gemini, und der RAID-Benchmark umfasst mehrere Modellfamilien. Eine Familie zu erkennen ist nicht dasselbe wie jeden Abschnitt zu erkennen: Die Studie von 2025 fand vollständig KI-geschriebene Einleitungen bei rund 50% auf Grammarly, und ein niedriger Wert belegt nicht, dass kein Assistent beteiligt war.
Ja, und Grammarly ist deutlich. Die Dokumentation erklärt, bedeutendes Umschreiben mit einem generativen Assistenten oder Paraphrasierer erhöhe den Wert, Text von externen Anbietern wie ChatGPT oder Gemini werde wahrscheinlicher höher eingestuft, und Umschreiben mit Grammarlys eigenen Umformulierungs- oder Humanisierungsagenten werde wahrscheinlich ebenfalls markiert, weil diese Umschreibungen aus einem Sprachmodell stammen.
Grammarly ist bei Benchmark-Material stark, das aufsatzähnliche Prosa enthält, und die RAID-Ergebnisse sind über Genres hinweg solide. Das überträgt sich nicht automatisch auf einen einzelnen Aufsatz. Grammarly selbst warnt, kürzere Abschnitte seien schwerer genau zu bewerten, und die unabhängige Studie fand absolute Werte weit unter dem tatsächlichen KI-Anteil in akademischen Einleitungen.
Ja. Grammarly schreibt im Nutzerhandbuch, kürzere Abschnitte seien schwerer genau zu messen als längere. Ein Wert aus zwei Sätzen verdient mehr Vorsicht als ein Wert aus einem ganzen Dokument, in dem sich Muster über mehrere Abschnitte wiederholen.
Das hängt von Benchmark, Version und Metrik ab, und ein einzelner Datensatz entscheidet es nicht. Im geprüften RAID-Stand lag der Grammarly-Eintrag beim AUROC über alle Bedingungen vor GPTZero. In der Studie von 2025 wurde GPTZero in der Pilotphase ausgeschlossen, weil es vollständig menschliches Schreiben oft als überwiegend KI einstufte, und die drei verbliebenen Tools waren untereinander uneinig. Vergleiche beide mit deinem eigenen Text.
Mit dem KI-Detektor vergleichen →Ja, und das ist erwartbar statt ein Zeichen für ein defektes Tool. Unterschiedliche Modelle, Trainingsdaten und Schwellen führen zu unterschiedlichen Lesarten. Grammarly sagt, sein Inhouse-Modell produziere Werte, die von Turnitin, GPTZero und Copyleaks abweichen, und die Studie von 2025 maß nur mäßige Übereinstimmung, ein ICC von 0,60, zwischen Grammarly und ZeroGPT auf identischen Texten.
Nicht allein. Grammarly empfiehlt, Detektor-Ausgaben als einzelnen Datenpunkt zu behandeln und automatische Erkennung mit manueller Prüfung zu verbinden. Ein tragfähiger Prozess kombiniert den Wert mit Prozessbelegen: Entwürfe, Versionsverlauf, ein Authorship-Bericht, Quellnotizen, frühere Arbeiten derselben Person und ein Gespräch über das Material.
KI-Erkennung liest den fertigen Text und schätzt, wie viel davon KI-Schreiben ähnelt. Authorship zeichnet auf, wie das Dokument entstand, und ordnet Text als geschrieben, aus einer Browserquelle eingefügt, aus unbekannter Quelle eingefügt, KI-generiert oder geschrieben und dann KI-umformuliert ein. Erkennung ist ein Ähnlichkeitswert, Authorship sind Belege zum Schreibprozess.
Ja, besonders wenn das Ergebnis Folgen hat. Grammarly sagt selbst, seine Werte könnten von anderen Detektoren abweichen und seine Prozentzahl sei keine Vorhersage dafür, was ein anderes Tool meldet. Eine zweite Lesart zeigt, ob der Text nahe an einer Entscheidungsgrenze liegt, und liefert weitere markierte Stellen zur Prüfung.
KI-Detektor nutzen →Ja. Füge denselben Abschnitt in den AI-2-Human Detektor ein und du erhältst eine weitere Lesart mit den Stellen, die noch generiert wirken. Zeigen beide Tools auf dieselben Stellen, verdienen sie eine genaue Prüfung. Widersprechen sie sich, weißt du, dass der Wert weich ist, und entscheidest mit mehr Kontext.
Meinen Text prüfen →Quellen und redaktionelle Hinweise
- Grammarly: Nutzerhandbuch zum KI-Detektor (auf Englisch)
- Grammarly: Produktseite des KI-Detektors (auf Englisch)
- Grammarly: Löst die Nutzung von Grammarly KI-Detektoren aus? (auf Englisch)
- Grammarly: Einführung in Authorship (auf Englisch)
- RAID: ein geteilter Benchmark zur robusten Bewertung von Detektoren für maschinengenerierten Text (auf Englisch)
- RAID-Benchmark-Leaderboard (auf Englisch)
- Advances in Simulation: Fähigkeit von KI-Detektoren und Menschen, KI-generierte Inhalte zu erkennen (2025, auf Englisch)
AI-2-Human ist weder mit Grammarly verbunden noch von Grammarly unterstützt. Die Produktdokumentation von Grammarly, Benchmark-Informationen und die zitierte Forschung wurden am 20. September 2026 eingesehen. Erkennungsmodelle und Benchmark-Leaderboards ändern sich, prüfe daher die aktuelle Grammarly-Dokumentation und das aktuelle RAID-Leaderboard, bevor du dich auf eine hier genannte Zahl verlässt.
Aktualisiert